Transformer의 비용은 토큰 사이의 Attention뿐 아니라 큰 선형 변환과 FFN에서도 발생하며, KV 캐시는 생성 중 과거 K·V의 중복 계산을 줄인다.
- 이전: 1편 · Encoder와 Decoder, 2편 · Q·K·V와 Multi-Head.
- 원 논문 내용: FFN과 사인·코사인 위치 인코딩.
- 추가 해설: 행렬 크기에서 유도한 시간복잡도, 자기회귀 추론의 KV 캐시. KV 캐시는 원 논문이 제시한 새 기법으로 소개하는 것이 아니라, 앞의 구조를 실제 생성 비용에 연결하는 보충 설명.
1. FFN: 위치별로 정보를 가공하기
- 구조: 선형 변환 → ReLU → 선형 변환.
- 원 논문 기본 차원:
512 → 2048 → 512. 중간 차원을 넓힌 뒤 잔차 연결이 가능한 원래 차원으로 복귀. - Position-wise: 모든 위치에 같은 함수를 독립적으로 적용. 같은 층의 가중치는 위치 사이에서 공유하고, 층 사이에서는 별개.
- Attention과의 차이: Attention은 토큰 사이의 정보를 섞고, FFN은 각 위치에 모인 정보를 비선형으로 가공.
- 범위: 위 식은 원 논문의 ReLU FFN. 후속 모델의 gated FFN 등과 구분.
기존 그림: Feed-Forward
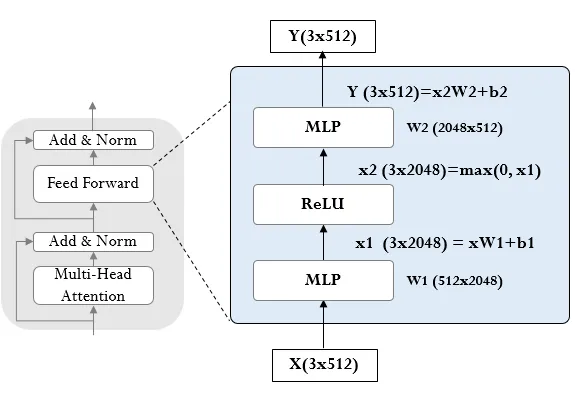
기존 그림 1 — 위치별 Feed-Forward. 추가 도표의 왼쪽 열과 대응. 수식과 구조의 기준: 원 논문 §3.3.
2. Positional Encoding: 순서를 어떻게 전달할까
원 논문은 토큰 임베딩에 같은 차원의 위치 벡터를 더해 순서를 전달한다.
| 기호 | 의미 |
|---|---|
pos |
시퀀스의 토큰 위치, 0부터 시작 |
i |
사인·코사인 차원 쌍의 인덱스 |
2i, 2i+1 |
같은 주파수를 사용하는 짝수·홀수 특성 차원 |
d_model |
임베딩과 위치 벡터의 차원 |
- 차원마다 다른 주기: 위치가 바뀔 때 여러 속도로 변하는 신호를 묶어 위치 벡터 구성.
- 덧셈: 위 블록 도표 오른쪽처럼
√d_model × Embedding + PE. 토큰 수나 벡터 차원을 늘리는 concat이 아님. - 적용 위치: 인코더·디코더 스택의 입력. 각 층마다 새로 위치 벡터를 더하는 구조로 설명하지 않음.
- 상대 위치의 단서: 고정된 거리만큼 이동한 사인·코사인 값을 원래 값의 선형 결합으로 표현할 수 있다는 것이 논문의 선택 근거 중 하나.
기존 그림: 위치 신호와 적용 예시
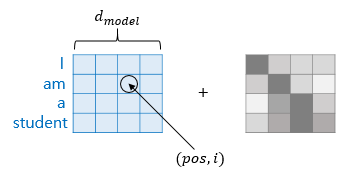
기존 그림 2 — 사인·코사인 위치 인코딩. 위 식의 위치·주파수 관계를 읽는 보조 자료.
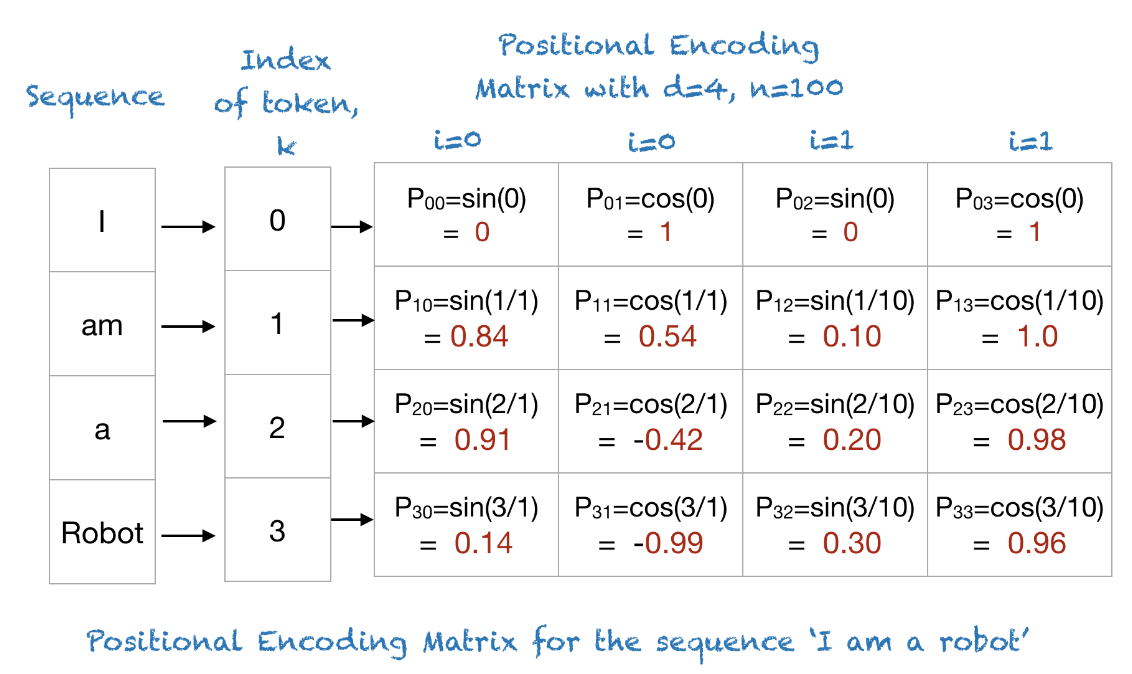
기존 그림 3 — 위치 인코딩 예시. 토큰의 의미 표현과 위치 표현을 함께 사용하는 맥락. 기존 참고자료인 Transformer 입문과 Encoder 해설은 아래에 유지.
| 비교 기준 | 고정 사인·코사인 위치 인코딩 | 학습형 절대 위치 임베딩 |
|---|---|---|
| 값의 생성 | 위치를 함수에 대입 | 위치별 벡터를 학습 |
| 위치용 학습 파라미터 | 없음 | 있음 |
| 학습 범위 밖 위치 | 함수 값을 계산 가능 | 테이블 확장·보간 등 별도 처리가 필요할 수 있음 |
| 긴 문장 성능 | 값의 계산 가능성이 성능을 보장하지는 않음 | 학습 범위와 확장 방법에 영향 |
- 원 논문의 실험: 두 방식에서 유사한 성능을 관찰. 더 긴 시퀀스에 외삽할 가능성을 고려해 사인·코사인 방식 선택.
- 한계: “학습형보다 항상 우수하다” 또는 “더 긴 문장에서도 정확하다”는 결론은 아님.
3. 왜 많은 연산이 필요한가
- 많은 토큰: Attention은 위치 쌍의 점수를 계산.
- 넓은 표현: Q·K·V 투영과 FFN은 큰 행렬 곱 사용.
- 깊은 스택: 같은 종류의 계산을 층마다 반복.
- 학습: 순전파에 역전파·가중치 업데이트를 더하고 많은 데이터에 반복.
- 생성: 새 토큰마다 모델을 통과. 병렬화 가능성과 총 연산량이 작다는 주장은 별개.
계산의 전제
| 기호 | 의미 |
|---|---|
n |
Self-Attention의 토큰 수 |
d |
모델 차원 d_model |
h |
head 수 |
d_h = d/h |
한 head의 Q·K·V 차원 |
d_ff |
FFN 내부 차원 |
L |
층 수 |
V |
어휘 크기; Value 행렬 V와 문맥으로 구분 |
- 가정: 표준 조밀한 Multi-Head Attention, 배치 1, 일반적인 행렬 곱. 희소 Attention·MoE·GQA 등은 이 표의 직접 대상이 아님.
- 시간복잡도의 의미: 총 산술 연산량의 차수. 실제 지연 시간은 메모리 이동·하드웨어·병렬화·커널 구현에도 영향.
- 기본 규칙:
[a × b] @ [b × c] → [a × c]의 연산량은O(abc). - 배치가
B이면 같은 길이의 입력 기준으로 대체로B배.
각 연산의 시간복잡도
| 계산 | 행렬 크기 또는 처리량 | 전체 head를 합친 비용 |
|---|---|---|
| 임베딩 조회·위치 덧셈 | n개 d차원 벡터 |
O(nd) |
| Q·K·V 투영 | 각각 [n,d] @ [d,d] |
O(nd²) |
| QKᵀ | head당 [n,d_h] @ [d_h,n] |
O(n²d) |
| 스케일링·마스크·softmax | head당 n × n 점수 |
O(hn²) |
| V 가중합 | head당 [n,n] @ [n,d_h] |
O(n²d) |
| 이어 붙인 결과의 출력 투영 | [n,d] @ [d,d] |
O(nd²) |
| 잔차 덧셈·LayerNorm | 각 위치의 d개 성분 |
각각 O(nd) |
| FFN의 두 선형 변환 | [n,d] @ [d,d_ff]와 역방향 폭 변환 |
O(nd·d_ff) |
| FFN 활성화 | n × d_ff개 원소 |
O(n·d_ff) |
- Q·K·V 세 번: 상수 3은 Big-O에서 생략.
- head 수:
h × n² × d_h = n²d. 고정된 전체 폭에서는 head 수가 행렬 곱 비용에 그대로 곱해지지 않음. - softmax:
h ≤ d라면O(hn²)는O(n²d)에 포함. - concat: 실제 복사 시
O(nd); view·레이아웃 처리로 복사를 피하는 구현도 가능. - Causal mask: 삼각 영역만 계산해도 위치 쌍이 제곱으로 증가한다는 차수는 동일.
한 층과 모델 전체
d_ff가d의 일정한 배수이면 한 층은O(nd² + n²d).- Self-Attention과 FFN 블록을
L층 쌓으면O(L(nd² + n²d)). - 어휘 출력층은 별도: 모든 위치에서 어휘 점수를 계산하면
O(ndV), softmax는O(nV). 마지막 위치만 사용하면 각각O(dV),O(V). - Cross-Attention 추가: 디코더 길이
m, 인코더 길이n일 때, Q·K·V 및 출력 투영과 Attention을 합쳐O((m+n)d² + mnd). 인코더–디코더 전체 비용은 각 스택과 Cross-Attention을 합산. - 학습: 역전파도 같은 규모의 행렬 곱을 포함하므로 같은 점근 차수에서 상수 비용 증가. 옵티마이저 업데이트 비용은 파라미터 수와 방식에 의존.
그러면 세제곱 복잡도인가
| 변화시키는 값 | 고정하는 값 | 증가 양상 |
|---|---|---|
입력 길이 n |
d, L |
n에 대해 선형 항과 제곱 항 |
모델 폭 d |
n, L, d_ff/d |
d에 대해 선형 항과 제곱 항 |
n과 d를 함께 2배 |
L, d_ff/d |
두 주요 항 모두 8배 |
층 수 L |
n, d |
선형 증가 |
n ≈ d ≈ N이라는 추가 전제에서는O(LN³)로 표현 가능.- 고정된 모델에 더 긴 입력을 넣는 경우를 세제곱이라고 부르면 부정확.
O(nd² + n²d)에서 어떤 변수를 늘리는지 명시해야 함. n이d보다 작으면 선형 변환·FFN 비용이 클 수 있고, 입력이 충분히 길어지면 토큰 간 Attention 비용의 비중이 커짐. 실제 경계는 상수와 구현에 의존.
4. KV 캐시: 과거 계산을 저장하고 새 위치만 처리하기
자기회귀 디코더에서는 뒤에 토큰이 추가되어도 과거 위치가 볼 수 있는 앞부분은 바뀌지 않으므로, 과거 K·V를 재사용할 수 있다.
- Prefill: 프롬프트 전체를 처리하고 각 층의 K·V를 저장. 마지막 위치의 출력에서 첫 생성 토큰 선택.
- Decode: 방금 선택한 토큰 한 개의 표현을 각 층에서 처리. 해당 층의 새 K·V를 추가하고 새 Q로 전체 캐시 참고.
- 층별 저장: 모든 층이 한 캐시를 공유하는 것이 아니라, 층마다 자기 입력 표현에서 만든 K·V 저장.
- Q를 저장하지 않는 이유: 지금 필요한 출력은 새 위치의 표현. 과거 위치의 query로 Attention 출력을 다시 계산할 필요 없음.
- 유효 조건: 동일한 가중치·앞부분 입력·위치 설정에서의 causal 추론. 앞부분 수정·양방향 Attention에는 단순한 재사용 논리를 그대로 적용할 수 없음.
- 동작 기준: Hugging Face 공식 문서 — How caching works.
이전 K·V와 현재 K·V는 concat인가
- 논리적으로 concat: K끼리, V끼리 각각 토큰 축으로 이어 붙임.
- 폭 유지: 한 head에서
[n, d_h] + [1, d_h] → [n+1, d_h].d_h를 늘리는 특성 축 concat이 아님. - 현재 토큰도 포함: 현재 Q는 과거 K·V와 현재 K·V를 함께 참고 가능.
- 다른 concat과 구분: Multi-Head 결과는 특성 축으로 결합하지만, KV 캐시는 시간에 따라 토큰 축으로 확장.
# shape: [batch, heads, tokens, head_dim]
# 동작 설명용: 단일 새 토큰, 표준 MHA, 패딩 없는 캐시
K = torch.cat([K_cache, k_new], dim=2)
V = torch.cat([V_cache, v_new], dim=2)
scores = (q_new @ K.transpose(-2, -1)) / math.sqrt(head_dim)
output = torch.softmax(scores, dim=-1) @ V
- 개념 코드: PyTorch와
mathimport, 위치 처리, 출력 투영, 배치별 길이·패딩 마스크 등은 생략. - 실제 메모리 구현: 매번
cat으로 전체 캐시를 복사하면 추가 비용 발생. 사전 할당한 공간이나 블록에 새 K·V를 기록하는 방식으로 논리적 concat 구현 가능. - 여러 새 토큰을 함께 처리: 위 단일 토큰 예시와 달리 새 토큰 사이의 causal mask도 필요.
계산과 메모리의 교환
| 항목 | 전체 n개 위치 처리 |
KV 캐시로 새 위치 1개 처리 |
|---|---|---|
| Q·K·V·출력 투영 | O(nd²) |
O(d²) |
| QKᵀ 및 V 가중합 | O(n²d) |
O(nd) |
| Attention softmax | O(hn²) |
O(hn) |
| FFN | O(nd·d_ff) |
O(d·d_ff) |
층당 합계, d_ff = O(d) |
O(nd² + n²d) |
O(d² + nd) |
- 표의 decode 열에서
n은 현재 토큰을 포함해 참고하는 문맥 길이. prefill 비용까지 없어진다는 뜻은 아님. - 생성 길이까지 합산: 프롬프트 길이
p뒤에서 한 토큰씩T번 decode하면, 캐시 갱신 복사를 제외한L층의 합은O(L(Td² + (pT+T²)d)). 한 단계가 문맥 길이에 선형이어도 여러 단계의 총 비용까지 선형인 것은 아님. - 위 합계에는 prefill과 각 단계의 어휘 출력 비용
O(TdV)는 별도. - 표준 MHA의 캐시 메모리: 대략
2 × B × L × n × d × 숫자당 바이트. 2는 K와 V, B는 배치 크기. 가중치·중간 버퍼·할당 오버헤드는 제외. - 남는 비용: 새 Q와 모든 K 비교, V 가중합, 새 위치의 FFN은 계속 필요. 긴 캐시는 저장 공간과 읽기 대역폭도 소비.
- 변형: GQA·MQA는 KV head 수를 줄여 캐시 크기를 달리함. 위 메모리 식은 모든 query head에 대응하는 KV head가 있는 표준 MHA 기준.
시리즈 연결과 참고자료
- 구조 다시 보기: 1편 — Encoder와 Decoder.
- 계산 원리 다시 보기: 2편 — Q·K·V와 Multi-Head.
- 원 논문: Attention Is All You Need, §3.3–3.5·§4.
- 추가 해설의 근거: Hugging Face — How caching works.
- 기존 참고자료: PyTorch 공식 코드.
- 기존 참고자료: Transformer 분석: Transformer의 Encoder 이해하기.
- 기존 참고자료: 딥 러닝을 이용한 자연어 처리 입문 16-1 Transformer.