Transformer는 입력 토큰의 정보를 서로 연결하고, 그 정보를 참고해 출력 토큰을 하나씩 예측하는 모델이다.
- 1편 · 현재 글: 입력 표현 → Encoder → Decoder → 학습과 생성.
- 2편 · Attention과 Multi-Head: Q·K·V → 참고 비율 → 가중합 → 여러 head의 결합.
- 3편 · FFN·위치 인코딩·연산량·KV 캐시: 나머지 구성 요소와 추론 비용.
- 읽는 기준: 2017년 원 논문의 인코더–디코더 Transformer. 번역 예시와 새 도표는 작성자의 해설이며, 편의상 단어를 토큰처럼 표시한다. 실제 토큰 경계는 토크나이저에 따라 다르다.
1. 무엇을 바꾼 논문인가
순환이나 합성곱 없이 Attention으로 토큰 사이의 정보를 연결해, 학습의 병렬성을 높인 것이 핵심이다.
| 관점 | RNN 기반 모델 | CNN 기반 모델 | Transformer |
|---|---|---|---|
| 층당 연산량 (핵심 연산) | (Self-Attention) | ||
| 토큰 간 연결 | 이전 위치의 상태를 다음 위치로 전달 | 주변 위치를 커널로 결합 | Self-Attention으로 허용된 위치를 직접 참고 |
| 같은 층의 위치 계산 | 순차 의존성 존재 | 위치별 병렬 계산 가능 | 위치별 병렬 계산 가능 |
| 먼 위치 사이의 경로 | 거리에 따라 길어짐 | 커널·확장 방식과 층 수에 의존 | 전체 Attention 한 번으로 직접 연결 |
| 주의할 비용 | 순차 계산으로 학습 병렬화 제약 | 먼 문맥을 연결할 층 필요 | 긴 입력의 토큰 쌍 계산 증가 |
-
복잡도 기호:
n은 입력 토큰 수,d는 표현 차원,k는 합성곱 커널 크기. -
비교 범위: 배치 1에서 입력 전체를 처리하는 순전파의 산술 연산량. 원 논문 Table 1의 표준 순환층·일반 합성곱·Self-Attention 핵심 연산 비교이며, 실제 실행 시간이나 KV 캐시를 쓴 한 토큰 생성 비용과는 구분.
-
Transformer 블록 전체: 표의
O(n²d)는 QKᵀ와 V 가중합 중심의 비용. Q·K·V 및 출력 투영과 FFN까지 포함하면O(nd² + n²d)(d_ff가d의 일정한 배수일 때). 연산별 유도는 3편 참고. -
Attention만 사용한다는 표현의 범위: RNN·CNN을 대체한다는 뜻. FFN, 임베딩, 잔차 연결, 정규화도 함께 사용.
-
원 논문의 결과: WMT 2014 영어→독일어에서 당시 최고 성능을 보고했고, 영어→프랑스어에서는 단일 모델 최고 성능을 보고. 모든 과제에서 항상 우월하다는 의미는 아님.
-
가중 평균의 한계: 여러 위치의 정보가 하나의 결과로 섞임. Multi-Head는 서로 다른 투영과 참고 비율로 이 한계를 완화하는 접근.
2. 번역 전체 흐름부터 보기
- Encoder: 원문을 읽고 각 입력 위치의 표현을 갱신.
- Memory: 인코더의 최종 출력. 입력 길이가
n이면n개 벡터가 유지되며, 문장 전체를 벡터 하나로 압축하지 않음. - Decoder: 원문 표현과 지금까지의 출력 토큰을 함께 참고.
- 출력층: 디코더 표현을 어휘별 점수로 변환하고 softmax로 다음 토큰 확률 계산.
- 생성: 선택한 토큰을 다음 단계 입력에 추가. 끝 토큰을 선택하면 종료.
3. 토큰을 벡터로, 위치를 숫자로
- 임베딩: 토큰 ID로 학습 가능한 표에서
d_model차원 벡터 조회. - 위치 인코딩: 토큰 순서를 전달하는 같은 차원의 벡터. 임베딩 뒤에 붙이지 않고 원소별로 더함.
- 원 논문의 입력: 임베딩에
√d_model을 곱한 뒤 위치 인코딩을 더함. - 첫 층 이전: 토큰과 위치의 표현. 문맥을 참고하는 계산은 다음 Self-Attention에서 수행.
- 위치 정보의 필요성: 같은 토큰 집합이라도 순서에 따라 의미가 달라질 수 있음. 구체적인 사인·코사인 식은 3편에서 설명.
4. Encoder: 문맥 정보를 모으고 가공하기
Attention은 위치 사이에서 정보를 모으고, FFN은 각 위치의 벡터를 가공한다.
- 인코더 한 층: Multi-Head Self-Attention → Add & Norm → FFN → Add & Norm.
- Self-Attention: 같은 층에 들어온 표현에서 Q·K·V를 생성. 패딩을 제외한 원문의 모든 위치를 참고 가능.
- FFN: 같은 가중치를 각 위치에 독립적으로 적용. 이 단계에서는 토큰 사이의 정보를 교환하지 않음.
- 잔차 연결: 기존 입력에 새 계산 결과를 더해 정보와 기울기가 흐를 경로를 제공.
- LayerNorm: 각 토큰의 특성 차원을 정규화. 원 논문은 잔차 덧셈 뒤에 정규화하는 Post-LN 구조.
- 스택: 원 논문은 구조가 같은 인코더 층 6개 사용. 층마다 가중치는 별개이며 기본 모델의
d_model = 512.
- 위 식과 보충 도표에서는 dropout 생략. 실제 원 논문은 서브레이어 출력에 dropout을 적용한 뒤 잔차 덧셈 수행.
기존 그림: 인코더 한 층과 전체 스택
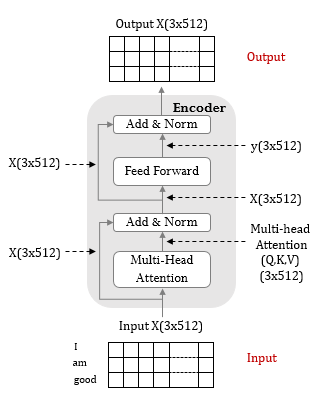
기존 그림 1 — 인코더 한 층의 구성. 새 블록 도표의 왼쪽 열과 대응.
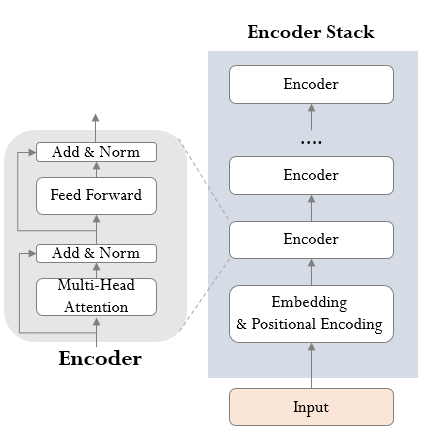
기존 그림 2 — 인코더 스택. 각 층의 출력이 다음 층의 입력으로 전달되는 흐름.
- 기존 그림을 원본 파일 그대로 보존. 기존 글이 연결한 해설 자료는 하단의 Transformer의 Encoder 이해하기 참고.
5. Decoder: 작성한 내용과 원문을 함께 참고하기
| 서브레이어 | Q를 만드는 표현 | K·V를 만드는 표현 | 참고 범위 |
|---|---|---|---|
| Masked Self-Attention | 현재 디코더 층의 입력 | 같은 디코더 층의 입력 | 현재 입력 위치와 그 이전 |
| Cross-Attention | 첫 Add & Norm을 지난 디코더 표현 | 인코더 스택의 최종 출력 | 패딩을 제외한 원문 전체 |
| FFN | 해당 없음 | 해당 없음 | 각 위치를 독립적으로 가공 |
- 디코더 한 층: 위 세 서브레이어 각각에 잔차 연결과 LayerNorm 적용.
- 스택: 원 논문은 디코더도 6층. 각 층의 Cross-Attention은 같은 인코더 최종 출력을 사용하되, 각자의 가중치로 K·V를 투영.
- 표현과 Q의 구분: 첫 Self-Attention의 출력 자체가 Cross-Attention의 Q는 아님. 잔차 연결·정규화를 지난 표현에 다음 어텐션의 Q 변환을 적용.
- 인코더 표현과 K·V의 구분: Memory 자체를 그대로 비교하는 것이 아니라, 학습된 변환으로 K·V 생성.
기존 그림: 디코더
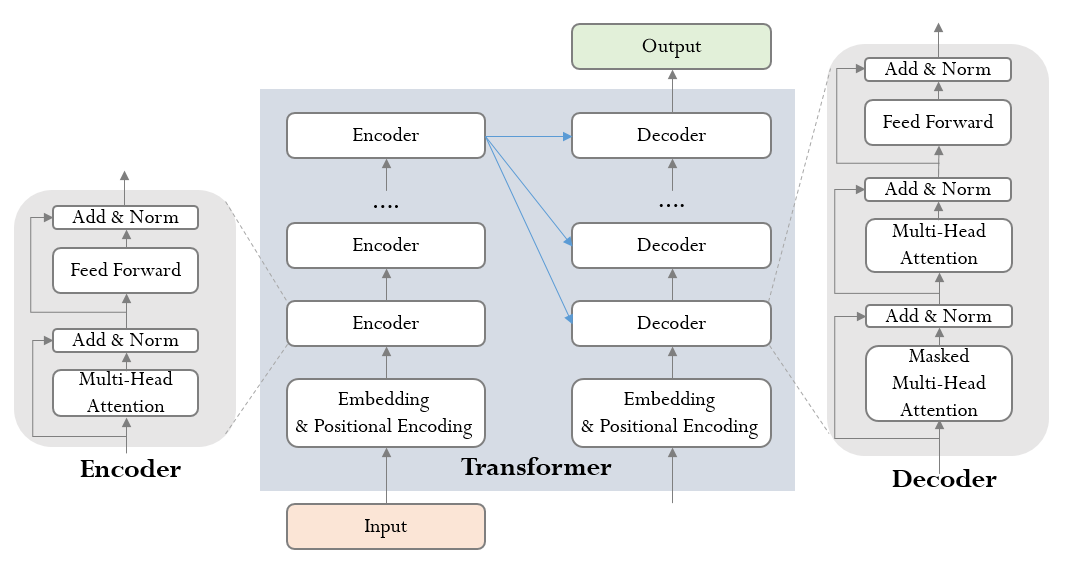
기존 그림 3 — 디코더의 두 어텐션과 FFN. 새 블록 도표의 오른쪽 열 및 위 Q·K·V 출처 표와 대응. 기존 참고자료는 아래에 유지.
계산 순서를 읽는 의사코드
encoder_layer(x):
    x = LayerNorm(x + SelfAttention(x, x, x))
    x = LayerNorm(x + FFN(x))
    return x

decoder_layer(y, memory):
    y = LayerNorm(y + MaskedSelfAttention(y, y, y))
    y = LayerNorm(y + CrossAttention(y, memory, memory))
    y = LayerNorm(y + FFN(y))
    return y
- 구조 설명용 의사코드: Attention 내부의 Q·K·V 투영, dropout, 패딩 마스크는 생략.
- 기존 Python 조각의 미정의 변수·내부 메서드 호출 대신 계산 순서를 명시. 실제 구현의 인자·마스크 규약은 PyTorch 공식 구현 참고.
6. 학습: 정답을 한 칸 밀고 미래를 가리기
현재 입력 토큰까지 읽고, 그 다음 토큰을 예측하도록 학습한다.
| 위치 | 디코더 입력 | 예측할 정답 | 해당 위치가 볼 수 있는 입력 |
|---|---|---|---|
| 0 | [시작] |
I |
[시작] |
| 1 | I |
am |
[시작] I |
| 2 | am |
a |
[시작] I am |
| 3 | a |
student |
[시작] I am a |
| 4 | student |
[끝] |
[시작] I am a student |
- Teacher forcing: 학습에서는 생성한 토큰 대신 정답의 앞부분을 입력으로 제공.
- Causal mask: 미래 입력 위치의 점수를 softmax 전에 가림.
a위치가 뒤의 정답student를 미리 보지 못하도록 제한. - 병렬 학습: 정답 입력 전체를 알고 있으므로 각 위치의 예측을 한 번의 순전파에서 계산 가능.
- 병렬화의 범위: 같은 층의 위치 계산을 병렬화. 층 사이의 의존성이나 실제 생성의 토큰 순서는 사라지지 않음.
7. 생성: 예측한 토큰을 다음 입력으로
- 자기회귀: 원문
x와 앞서 생성한 토큰 전체y_<t에 조건을 두고 다음 토큰 예측. - 이전 토큰 하나만 사용한다는 뜻도, 고전적인 선형 AR 시계열 식을 그대로 적용한다는 뜻도 아님.
- 실제 생성: 다음 토큰을 알아야 다음 입력을 만들 수 있으므로 토큰 단위로 순차 진행.
- 중복 계산 감소: 과거 K·V를 저장하는 KV 캐시를 적용할 수 있음. 3편의 추론 해설에서 concat 축과 복잡도까지 연결.
| 구분 | 학습 | 생성 |
|---|---|---|
| 앞부분 입력 | 정답 토큰 | 모델이 선택한 토큰 |
| 미래 토큰 | 알고 있지만 마스크로 차단 | 아직 생성되지 않음 |
| 위치별 예측 | 한 번에 병렬 계산 가능 | 다음 토큰을 순서대로 생성 |
| 가중치 | 오차로 업데이트 | 고정된 가중치 사용 |
다음 편과 참고자료
- 다음: 2편 — Q·K·V와 Multi-Head Attention.
- 원 논문: Attention Is All You Need, §1–3·§6.
- 기존 참고자료: PyTorch 공식 코드.
- 기존 참고자료: Transformer 분석: Transformer의 Encoder 이해하기.