Anthropic 원문의 번역·요약 및 해설. 원문 전체의 직역본이 아니며, 추가 도표와 시리즈 연결은 작성자의 해설로 구분.
- 원문: Demystifying evals for AI agents
- 함께 읽기: 에이전트 평가 시리즈 허브
- 읽는 순서: 구성 블록 → trial 시퀀스 → grader 비교 → 운영 흐름
- 모바일 읽기: 그림을 누르면 확대 보기; 비교표는 영역 안에서 좌우로 스크롤
- 그림 구분: Anthropic 원본 그림 5개 유지. 아래의 한국어 블록·시퀀스 다이어그램은 원문 개념을 재구성한 보충 해설.
Introduction: 왜 agent eval이 필요한가
좋은 평가는 행동의 변화를 사용자에게 노출하기 전에 발견하고, 운영에서 찾은 실패의 재발을 막는 개발 feedback 장치다.
- 평가 없는 개발: 운영에서 문제 발견 → 원인을 추측해 수정 → 다른 회귀를 다시 운영에서 발견
- Agent의 복잡성: 여러 turn의 tool 호출, environment state 변경, 중간 결과에 따른 다음 행동 조정
- 재현의 어려움: agent를 유용하게 만드는 자율성·지능·유연성이 실행 결과의 변동성도 확대
- 함께 기록할 대상: 주어진 환경, 관찰 내용, 행동, 실제로 만들어진 최종 상태
- 누적되는 자산: 실패 사례, 성공 조건, grader를 축적해 agent lifecycle 전반의 변경 검증에 활용
한눈에 보는 평가 구조 — 보충 블록 다이어그램
- 바깥 실행 계층: evaluation harness가 task 준비·trial 실행·기록·채점·집계 담당
- 안쪽 행동 계층: model과 agent harness가 tool을 통해 environment와 상호작용
- 두 갈래의 증거: 실행 과정인 transcript, 환경의 최종 상태인 outcome
- 판정의 기준: task의 성공 조건에 맞춰 두 증거에 적절한 grader 적용
The structure of an evaluation
Evaluation은 입력을 주고 grading logic으로 성공 여부를 측정하는 test다.
- 원문의 범위: 실제 사용자 없이 개발 중 반복 실행하는 automated eval
- 보완 신호: production monitoring, A/B test, 사용자 feedback으로 실제 사용 분포 확인
Single-turn에서 agent evaluation으로
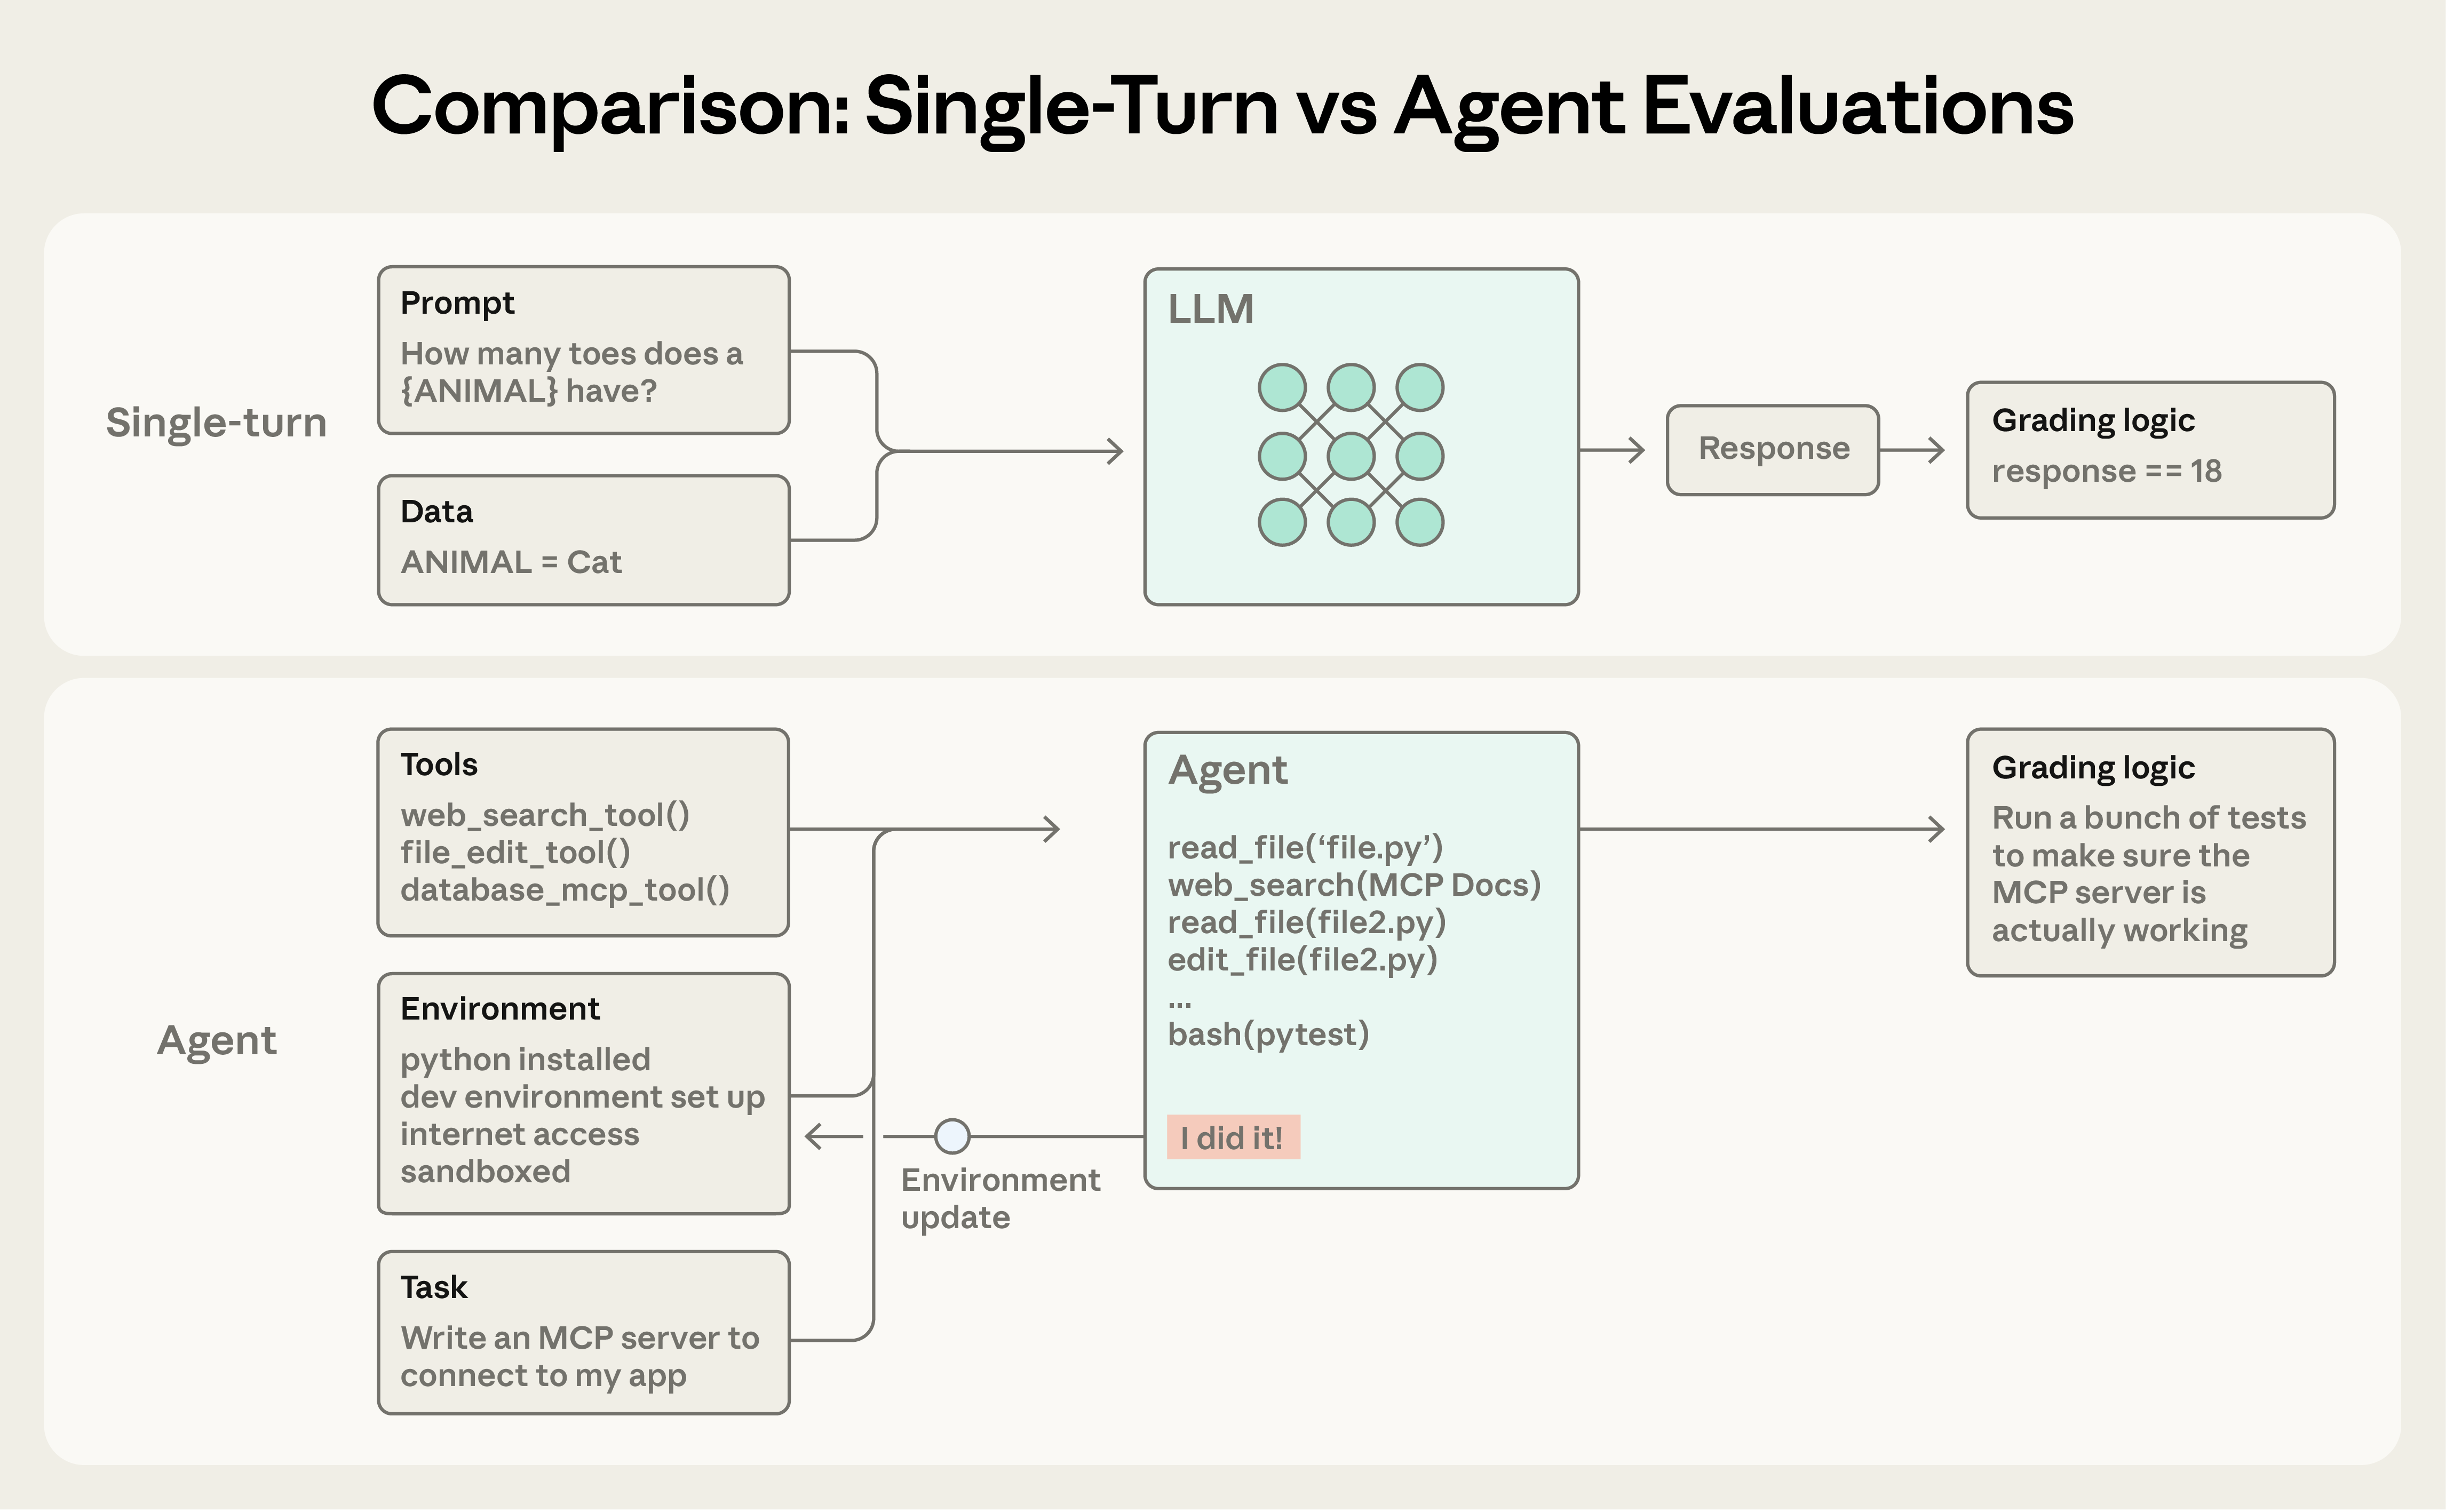
Single-turn evaluation과 agent evaluation의 구조 비교. 출처: Anthropic, Demystifying evals for AI agents.
| 비교 기준 | Single-turn evaluation | Agent evaluation |
|---|---|---|
| 제공 대상 | Prompt | Task, tool, 실행 가능한 environment |
| 실행 흐름 | 응답 한 번 생성 | 여러 turn의 행동·관찰·상태 변경 |
| 판정 대상 | Response | Transcript와 최종 environment state |
| 주요 어려움 | 응답의 정확성·품질 판정 | 오류 누적, 환경 재현, 다양한 정상 해결 경로 |
Agent 평가는 실행 과정 전체와 마지막 환경 상태를 함께 판정해야 한다.
- 오류 전파: 앞선 tool 호출의 작은 오류가 이후 판단에 영향
- 다양한 정상 경로: 정적 reference에 없는 더 나은 해법도 존재 가능
- 실패 구분: agent의 잘못과 rigid한 grader·evaluation specification의 한계를 별도로 확인
평가를 구성하는 기본 단위
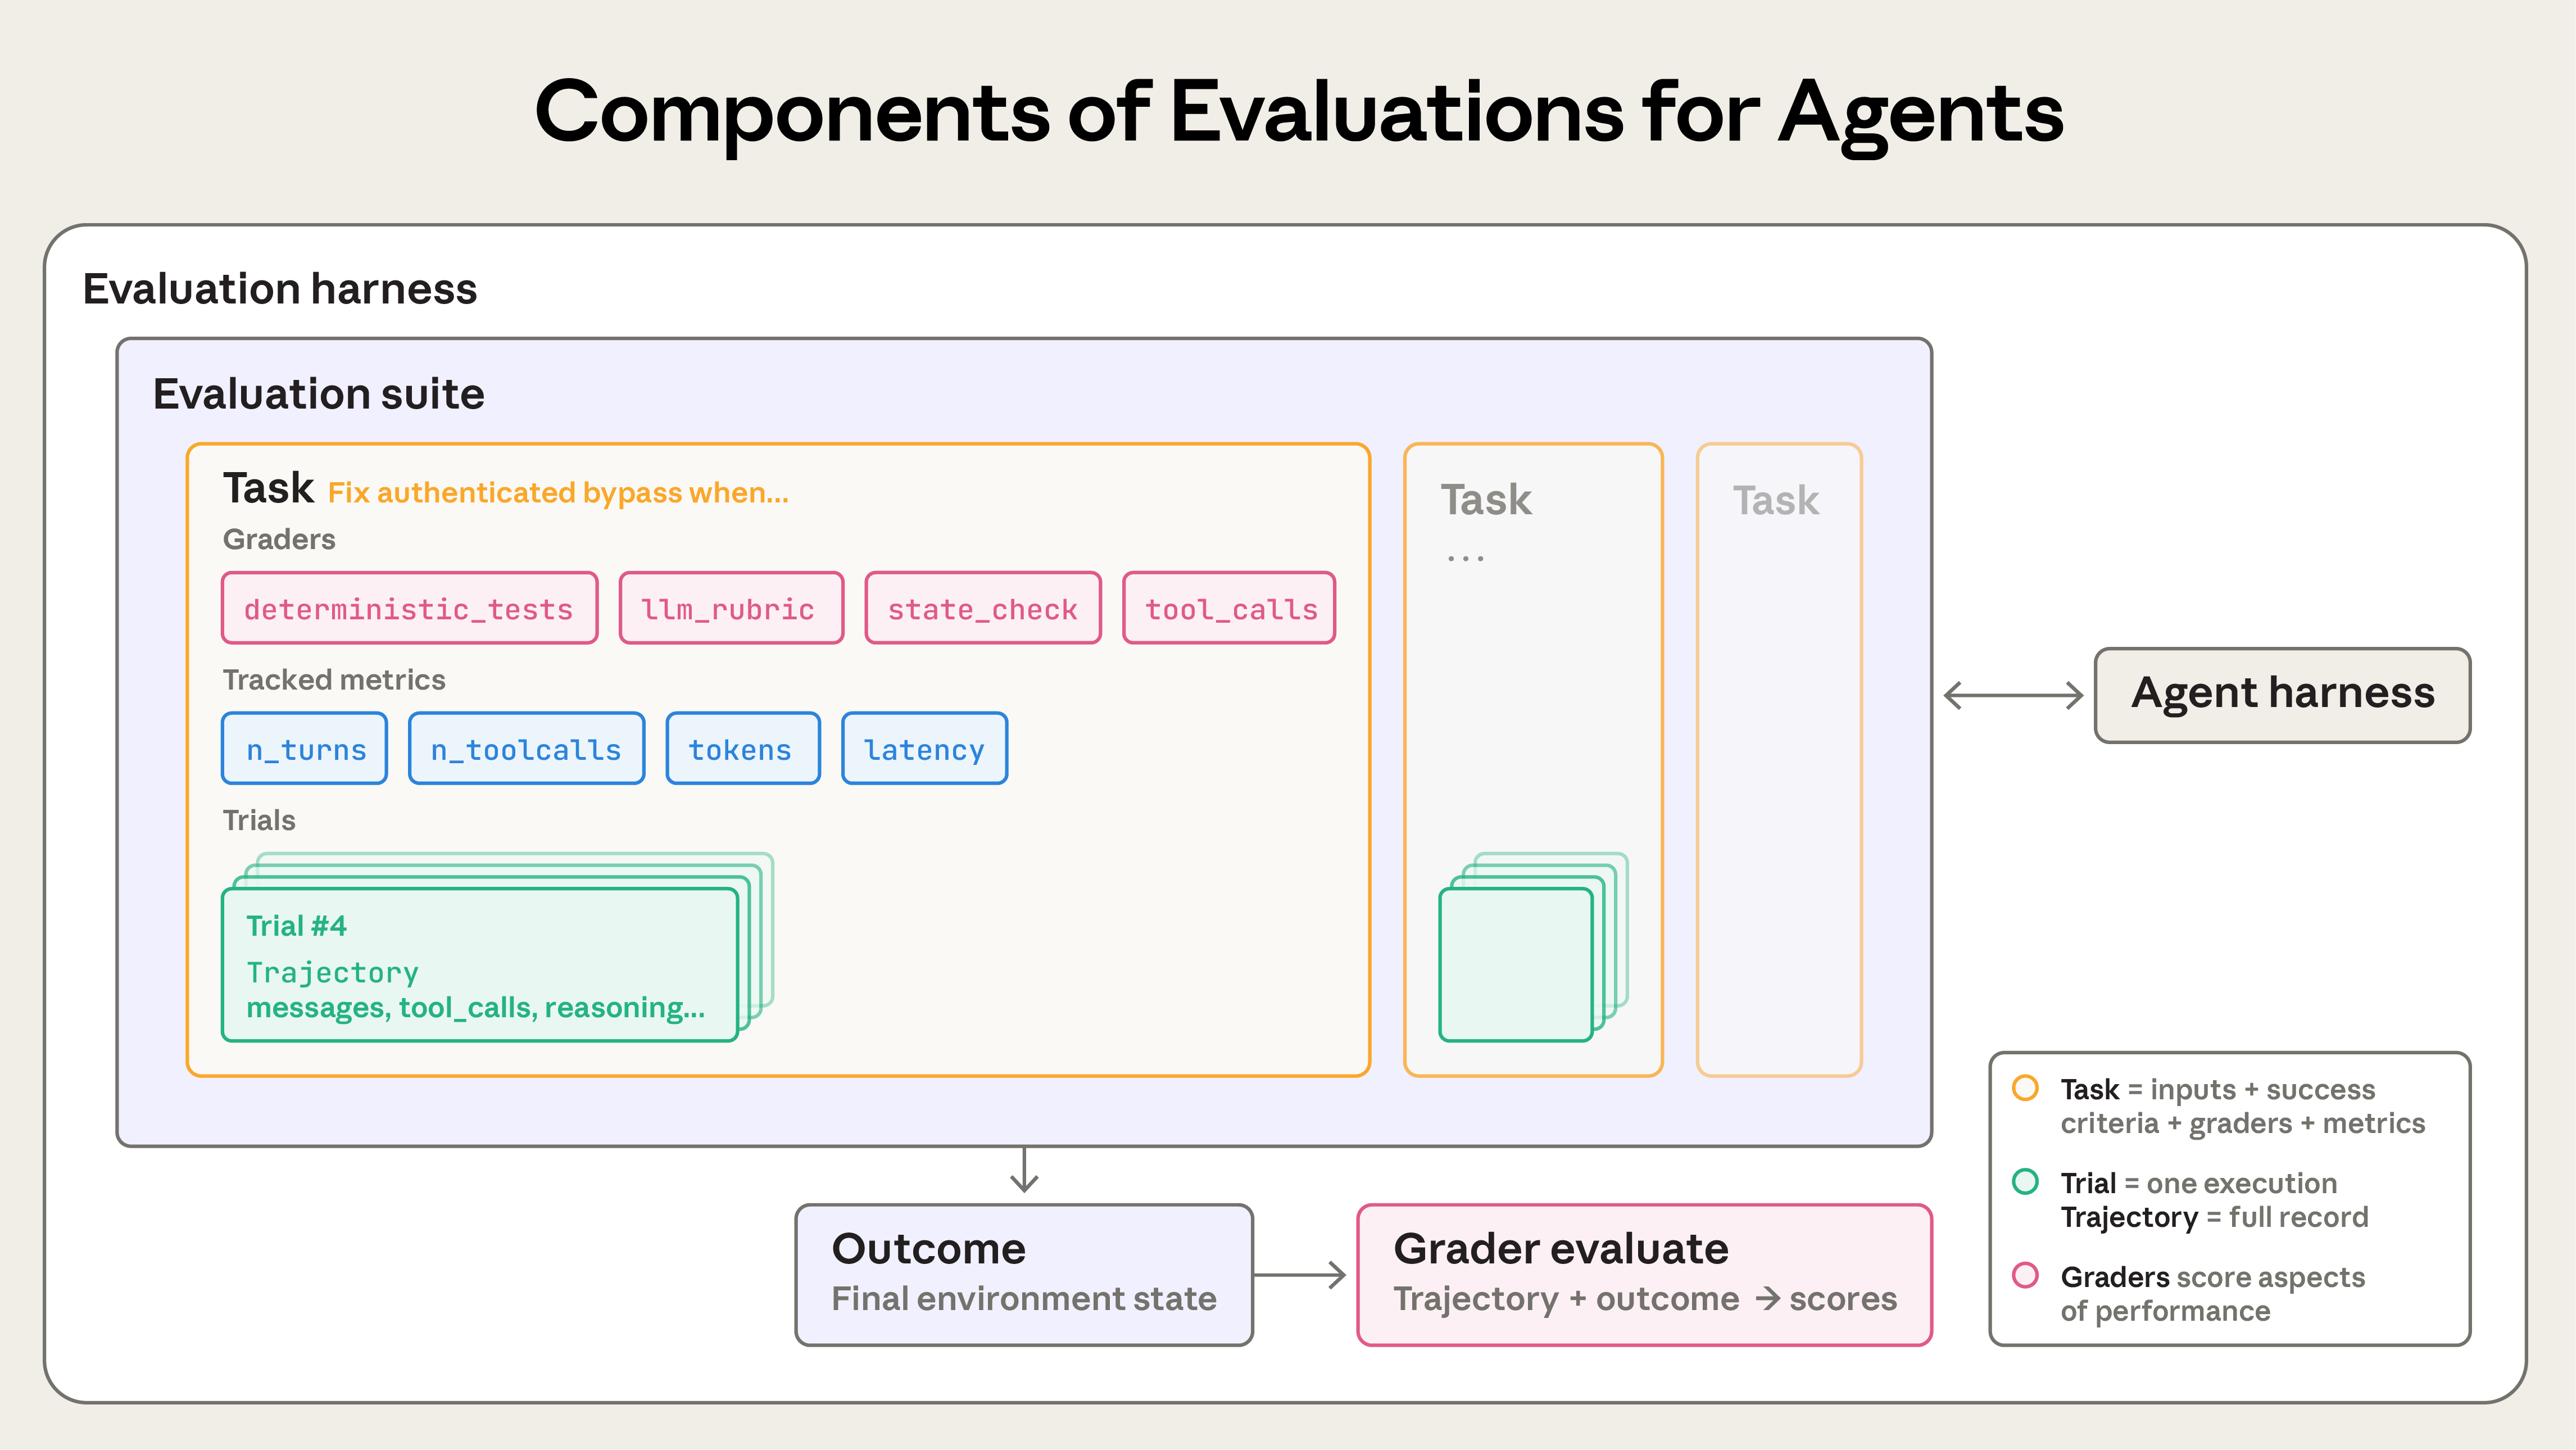
Agent evaluation의 구성 요소. 출처: Anthropic, Demystifying evals for AI agents.
| 원문 용어 | 의미와 책임 |
|---|---|
| Task / problem / test case | 입력과 성공 조건이 정의된 하나의 평가 문제; grader·추적 metric 연결 |
| Trial | 같은 task를 한 번 실행한 시도; 출력 변동성을 보기 위해 반복 |
| Grader | 행동이나 결과의 특정 측면을 판정하는 로직; 여러 assertion 포함 가능 |
| Transcript / trace / trajectory | Model output, tool call, 중간 상호작용을 포함한 trial 전체 기록 |
| Outcome | Trial 종료 시 environment에 남은 최종 상태 |
| Evaluation harness | Task 실행·기록·채점·결과 집계 담당 |
| Agent harness / scaffold | Model의 입력 처리·tool 호출·결과 반환을 orchestration |
| Evaluation suite | 공통 capability나 behavior를 측정하는 task 집합 |
“Agent 성능”은 model과 agent harness가 함께 동작한 결과다.
| 구분 | Evaluation harness | Agent harness |
|---|---|---|
| 주요 책임 | 평가 실행과 측정 | Model이 agent로 행동하도록 지원 |
| 관리 대상 | Suite, trial, 증거 기록, grader, 집계 | Prompt, tool orchestration, 실행 제약 |
| 평가 시 확인 | 동일 조건·격리·판정의 신뢰성 | Model과 함께 실제 행동에 미친 영향 |
한 trial의 실행과 판정 — 보충 시퀀스 다이어그램
- 준비: task의 입력·성공 조건에 맞춰 trial마다 깨끗한 environment 구성
- 반복: agent의 tool 호출 → environment의 상태 변경·observation → 다음 행동
- 기록: 실행 중 message·tool call·중간 결과를 transcript로 축적
- 종료: 최종 응답과 별개로 실제 environment state를 outcome으로 확인
- 채점·집계: transcript·outcome의 해당 측면을 grader로 판정하고 여러 trial의 결과 집계
- 도표의 범위: 원문 개념을 설명하기 위한 논리적 순서; 특정 framework의 API·통신 구조를 규정하지 않음
Transcript와 outcome은 같은 것이 아니다
“완료했다”는 응답과 실제 완료 상태는 별개의 증거다.
| 확인할 증거 | 주요 검사 | 단독 사용 시 놓치는 문제 |
|---|---|---|
| Outcome | 최종 파일, database state, test 통과, 실제 부작용 | 결과는 맞지만 정책 위반·비효율적 반복이 있었던 경우 |
| Transcript | Tool 사용, 금지 행동, turn 수, 상호작용 품질 | 완료를 선언했지만 실제 상태가 바뀌지 않은 경우 |
- 정상 경로가 여러 개인 task: 하나의 trajectory를 정답으로 강제하지 않고 outcome 중심 판정
- 경로 자체가 계약인 task: 안전 정책·필수 확인 단계도 transcript에서 명시적으로 검사
Why build evaluations?
Eval은 초기에는 성공의 의미를 명시하는 specification이고, 운영 이후에는 확보한 품질을 지키는 regression safety net이다.
- 초기 개발: manual test, dogfooding, 팀의 직관으로 빠른 반복 가능
- 규모 확장: “전보다 나빠졌다”는 제보만으로 실제 회귀와 실행 노이즈를 구분하기 어려움
- 요구사항 구체화: task·grader 작성 과정에서 구성원 간 edge case 해석 차이 발견
| 사례 | 출발점 | Eval이 발전한 방향 |
|---|---|---|
| Claude Code | 내부·외부 feedback 중심 반복 | 간결성·파일 수정에서 더 복잡한 behavior 평가로 확장 |
| Descript | 편집 안전성·요청 이행·품질 정의, manual grading | LLM grader와 정기 human calibration; quality benchmark·regression suite 분리 |
| Bolt | 제품이 널리 사용된 뒤 eval 구축 | Static analysis·browser agent·LLM judge를 판정 문제별로 사용 |
- 변경 비교: 고정 task bank로 model·prompt·agent harness를 같은 조건에서 비교
- Baseline 추적: latency, token usage, task당 비용, error rate 함께 기록
- 팀 간 공통 언어: product의 성공 조건을 research가 개선할 task·metric으로 표현
- 투자 효과: 구축 비용은 먼저 발생하고, 재사용·회귀 방지의 이점은 이후 누적
How to evaluate AI agents
Task와 environment를 명확히 정의하고, 증거의 성격에 맞는 grader를 조합한다.
Types of graders for agents
| Grader | 적용 방법 | 강점 | 한계·관리 조건 |
|---|---|---|---|
| Code-based | Exact·regex·fuzzy match, binary test, static analysis, outcome·tool call 검증, turn·token 분석 | 빠름·저비용·객관성·재현성; 실패 원인 추적 용이 | 정상 변형을 오판할 수 있음; 뉘앙스·주관적 품질에 한계 |
| Model-based | Rubric, 자연어 assertion, pairwise comparison, reference 평가, 여러 judge의 합의 | 열린 결과·복합 조건에 유연; 대량 평가 확장 가능 | 비결정성·추가 비용; human label과 calibration 필요 |
| Human | Domain expert review, crowdsourcing, spot check, A/B test, 평가자 간 합의 측정 | 복잡하고 주관적인 문제의 기준점; 전문 사용자 판단; model grader 교정 | 높은 비용·소요 시간; 전문가 확보·평가자 일관성 관리 필요 |
- 상담 task의 분리 예: 해결 상태는 state check, turn 제한은 transcript constraint, 어조는 model·human rubric
- 설계 원칙: 한 grader의 점수로 모든 품질을 대표하지 않음
| 점수 결합 방식 | 통과 기준 | 적용 시 확인 |
|---|---|---|
| Weighted score | 가중 점수 합이 기준 충족 | 항목별 비중과 상쇄 가능성 |
| Binary gate | 필수 조건 모두 통과 | 반드시 지켜야 하는 성공 조건 |
| Hybrid | 필수 조건과 가중 점수 결합 | 필수 항목과 품질 항목의 구분 |
Capability vs. regression evals
| 비교 기준 | Capability eval | Regression eval |
|---|---|---|
| 질문 | 얼마나 어려운 문제까지 풀 수 있는가? | 이미 하던 행동을 계속 안정적으로 수행하는가? |
| Task 구성 | 아직 자주 실패하는 어려운 문제 | 이미 확보한 행동을 확인하는 문제 |
| 기대 신호 | 개선 방향을 드러내는 낮은 초기 통과율 | 거의 모든 trial 통과; 하락 시 회귀 점검 |
| 운영 | 더 어려운 문제를 지속 추가 | 지속 실행하며 기존 품질 유지 |
- 포화된 capability task: 삭제 대신 regression suite로 승격
- 새 capability task: 더 어려운 failure mode를 추가해 개선 신호 유지
Evaluating coding agents
Correctness test와 code-quality rubric에서 시작하고, 필요한 신호를 추가한다.
- 실행 조건: 명확한 task, 안정적인 environment, 충분한 test
- 결과 판정: 생성 code 실행 여부와 기존 동작 보존을 deterministic test로 확인
- 추가 증거: static analysis, repository state, security log
- 과정·품질 보완: 불필요한 수정, tool 사용 방식, 사용자 소통을 heuristic·model rubric으로 판정
Example: coding agent evaluation
- 예제 목적: 접근 제어 결함 수정 task에 여러 grader·운영 metric을 배치하는 구조 설명
- 작성자 재구성: 원문의 예시를 일반화한 YAML; 특정 도구의 실행 가능한 설정 파일은 아님
- 적용 범위: 가능한 grader를 넓게 보여 주는 예시; 실제로는 correctness·code quality부터 도입
보충 예제: coding task의 grader·metric 구성 펼치기
task:
  id: patch-access-control
  description: "빈 credential로 보호된 resource에 접근하지 못하게 수정한다"

graders:
  - type: deterministic_tests
    required:
      - rejects_empty_credential
      - rejects_missing_credential

  - type: llm_rubric
    rubric: rubrics/code_quality.md

  - type: static_analysis
    commands: [lint, typecheck, security_scan]

  - type: state_check
    expect:
      audit_event: access_denied

  - type: tool_calls
    required: [inspect_source, edit_source, run_tests]

tracked_metrics:
  transcript: [turns, tool_calls, total_tokens]
  latency: [time_to_first_token, time_to_completion]
Evaluating conversational agents
Conversational agent는 목표 달성뿐 아니라 상호작용의 품질도 평가한다.
- 실제 상태: ticket 해결·반품 처리 여부를 state check로 확인
- 대화 과정: turn 제한, 정책 준수, 어조를 각각 적절한 grader로 판정
- 여러 turn 생성: user simulator 활용 가능; simulator의 일관성·현실성도 측정값에 영향
- 여러 정상 응답: communication quality·goal completion은 model-based grader로 보완
Example: conversational agent evaluation
- 원문 사례: 불만을 가진 사용자의 환불 요청 처리
- 작성자 재구성: 같은 다차원 평가 구조를 반품 요청 task로 일반화
- 판정 분리: 응답 품질·목표 달성 평가와 실제 상태 변경 검증을 함께 사용
보충 예제: conversational task의 grader·metric 구성 펼치기
task:
  id: resolve-return-request
  description: "사용자 확인을 거쳐 반품 요청을 처리하고 결과를 설명한다"

graders:
  - type: llm_rubric
    rubric: rubrics/interaction_quality.md
    assertions:
      - "사용자의 불편을 적절히 인지했는가"
      - "처리 결과와 다음 단계를 명확히 설명했는가"
      - "정책 조회 결과에 근거해 답했는가"

  - type: state_check
    expect:
      request_status: resolved
      return_status: accepted

  - type: tool_calls
    required: [verify_user, create_return, send_notice]

  - type: transcript
    max_turns: 10

tracked_metrics:
  transcript: [turns, tool_calls, total_tokens]
  latency: [time_to_first_token, time_to_completion]
Evaluating research agents
Research 품질은 task의 목적에 따라 판정 기준이 달라진다.
- 열린 정답: 충분한 포괄성·신뢰할 만한 출처·근거 연결의 의미를 task별로 정의
- Groundedness: 주장이 수집한 근거로 뒷받침되는지 확인
- Coverage: 답변에 반드시 포함할 핵심 사실 확인
- Citation·source quality: 인용 연결과 출처의 신뢰성 확인
- Calibration: domain expert·human review로 주관적 판단 기준 보완
Computer-use agents
성공 메시지보다 실제 backend·file·application state를 확인한다.
- 실행 환경: 실제 또는 sandboxed browser·OS에서 GUI 조작
- 조작 수단: screenshot, mouse, keyboard, scroll
- 완료 증거: backend state, 파일, application configuration, UI property
| 관찰·조작 방식 | 주요 특성 | 평가할 선택 |
|---|---|---|
| DOM 기반 | 빠른 상호작용; 많은 token을 사용할 수 있음 | 텍스트 추출이 적합한 상황에서 선택했는가? |
| Screenshot 기반 | 상대적으로 느린 상호작용; 화면 task에서 token 효율이 나을 수 있음 | 시각적 탐색이 적합한 상황에서 선택했는가? |
- 확인 대상: task 성격에 맞는 tool 선택과 그에 따른 latency·token 사용
How to think about non-determinism
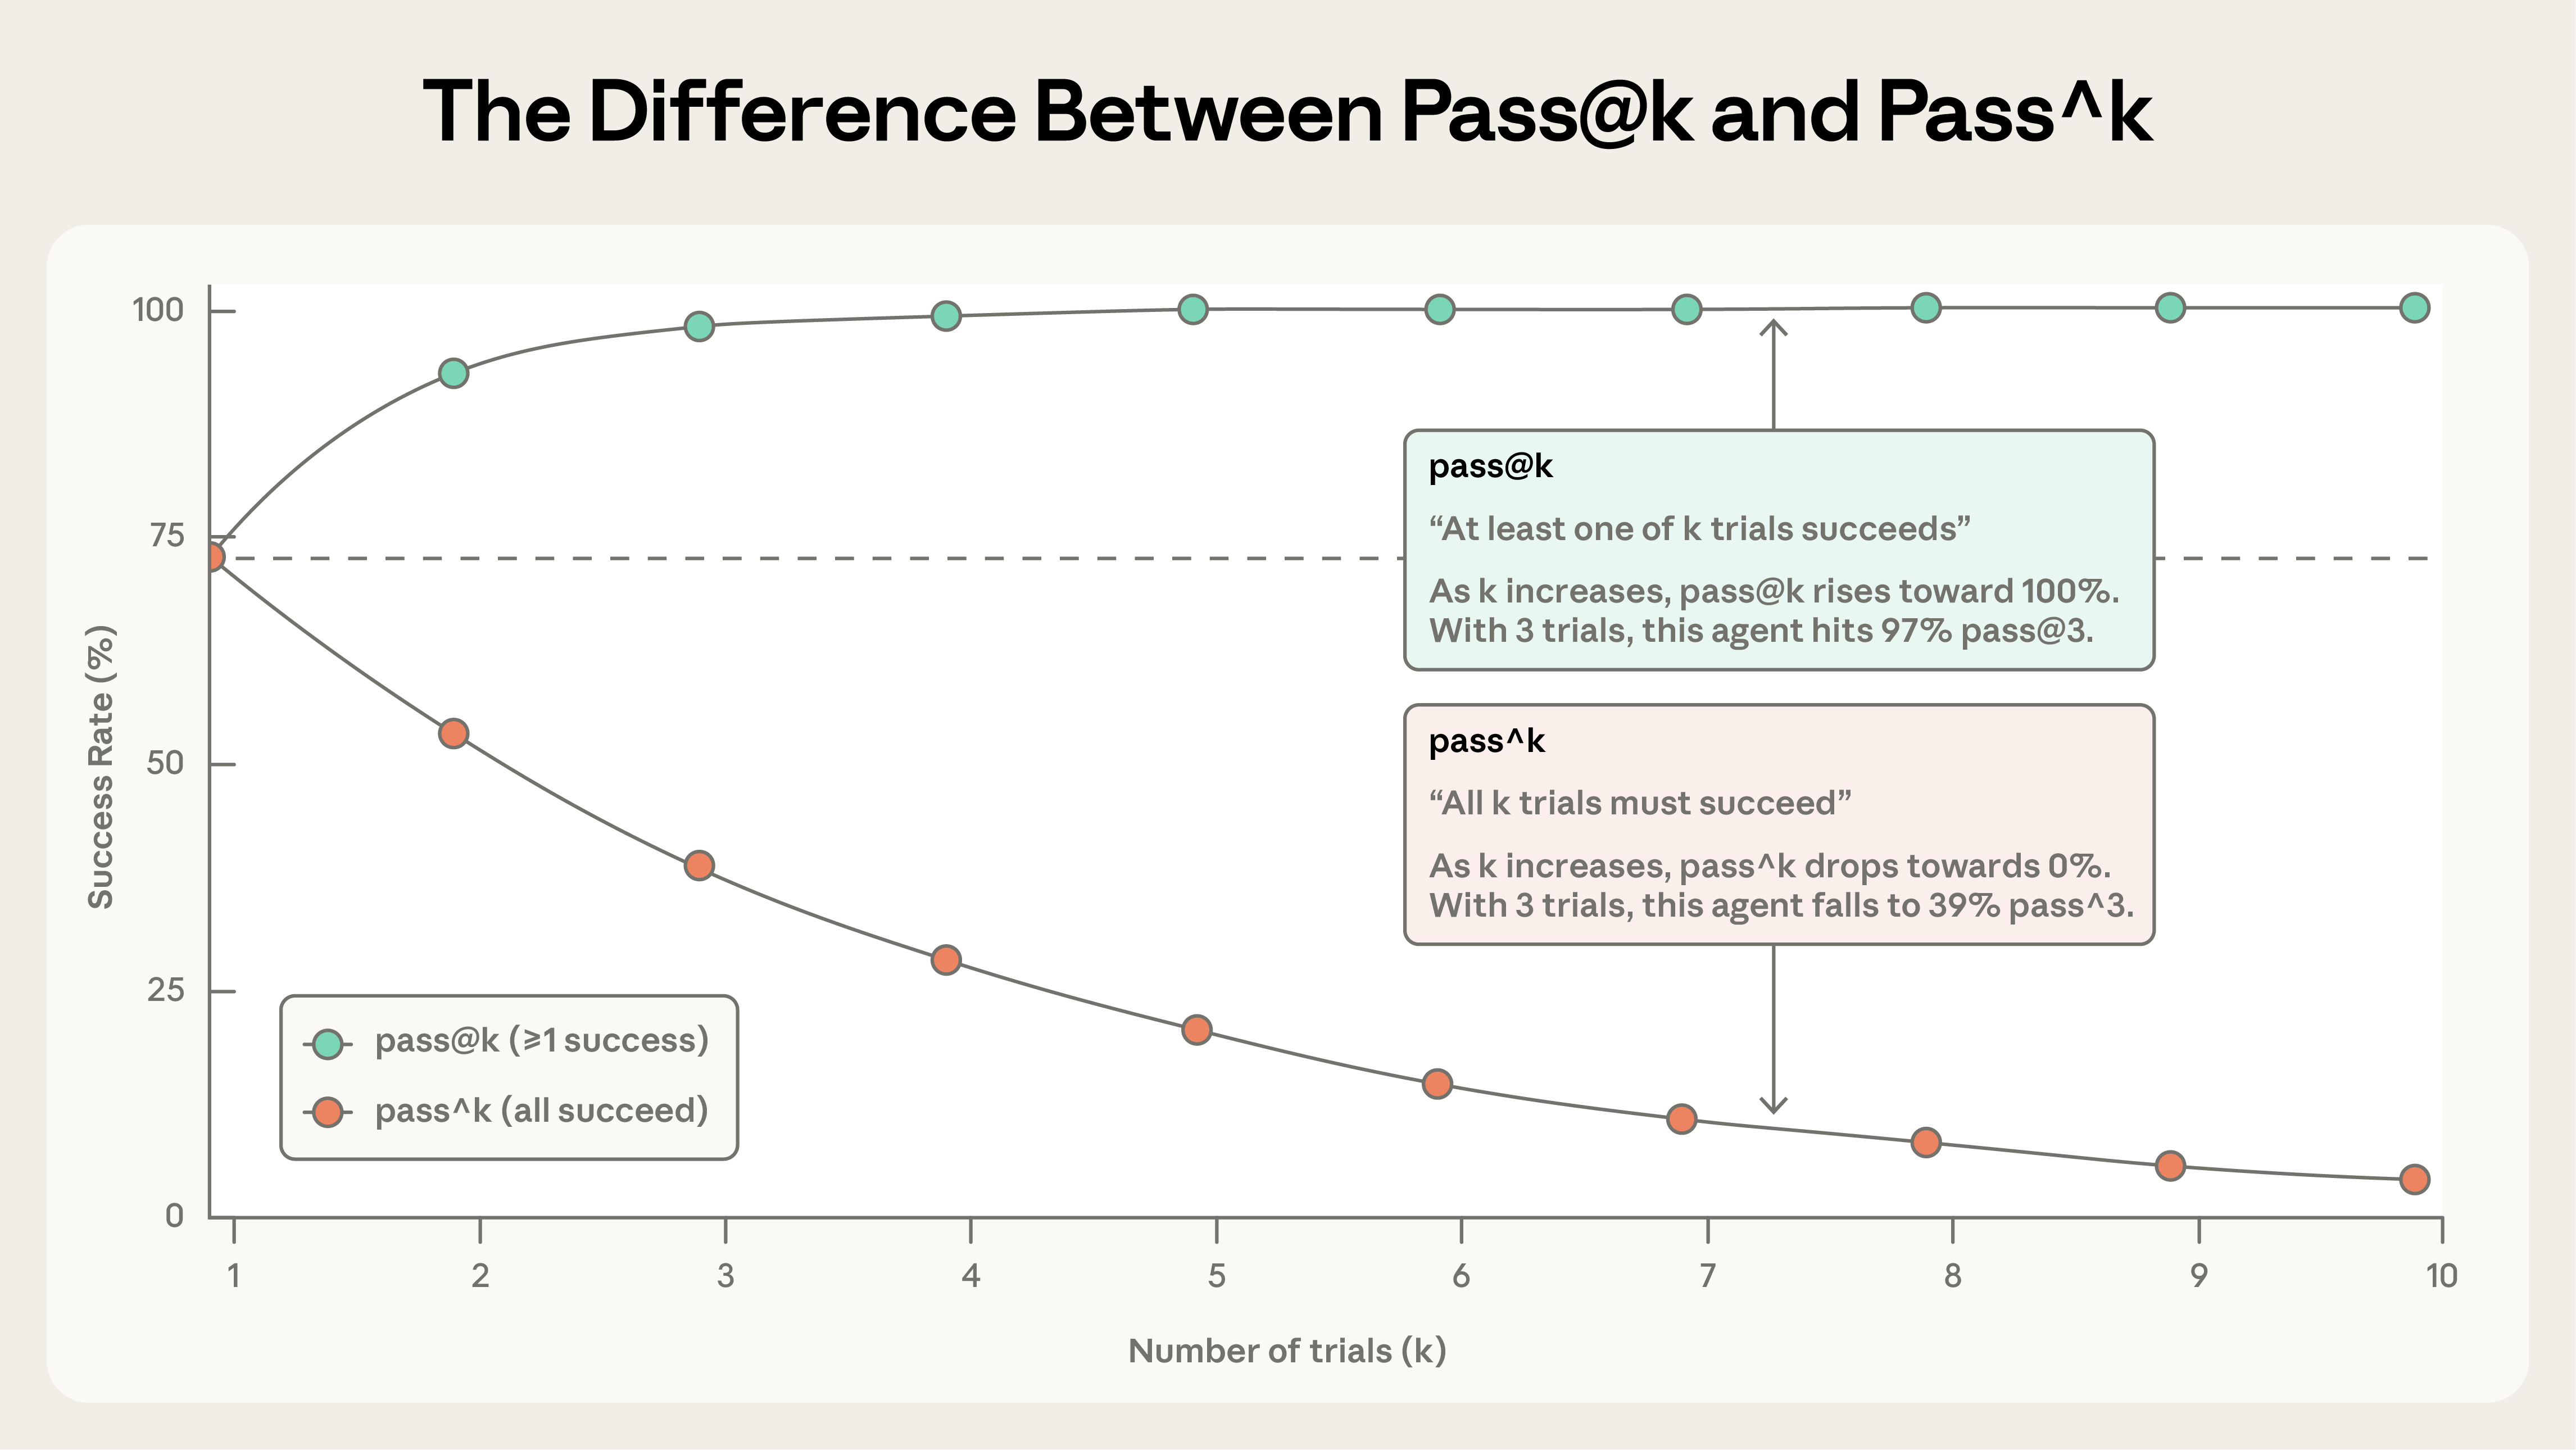
Trial 수가 늘어날 때 pass@k와 pass^k가 반대 방향으로 움직이는 모습. 출처: Anthropic, Demystifying evals for AI agents.
“여러 번 중 한 번 해결”과 “반복할 때마다 안정적으로 해결” 중 무엇이 필요한지 먼저 정한다.
| 비교 기준 | pass@k | pass^k |
|---|---|---|
| 의미 | k번 중 한 번 이상 성공할 가능성 | k번 모두 성공할 가능성 |
| k 증가 시 | 상승 | 하락 |
| 적합한 요구 | 여러 후보 중 하나만 성공해도 유효 | 매번 안정적인 행동 필요 |
| k = 1 | 첫 시도의 성공률 | 첫 시도의 성공률 |
- 반복 이유: 같은 agent·task도 실행마다 결과 변동
- Task별 차이: task마다 다른 성공률; 한 run의 pass가 다음 run의 pass를 보장하지 않음
- 해석 단위: 한 번의 pass/fail보다 반복 trial의 성공 분포 확인
Going from zero to one: a roadmap to great evals
좋은 eval은 task 수집·실행·채점·검토를 반복하며 유지하는 자산이다.
- 도표의 의미: 원문의 세 단계와 운영 feedback을 연결한 작성자의 보충 해설
- 세 단계: evaluation suite 개발 → harness·grader 개발 → 장기 유지보수
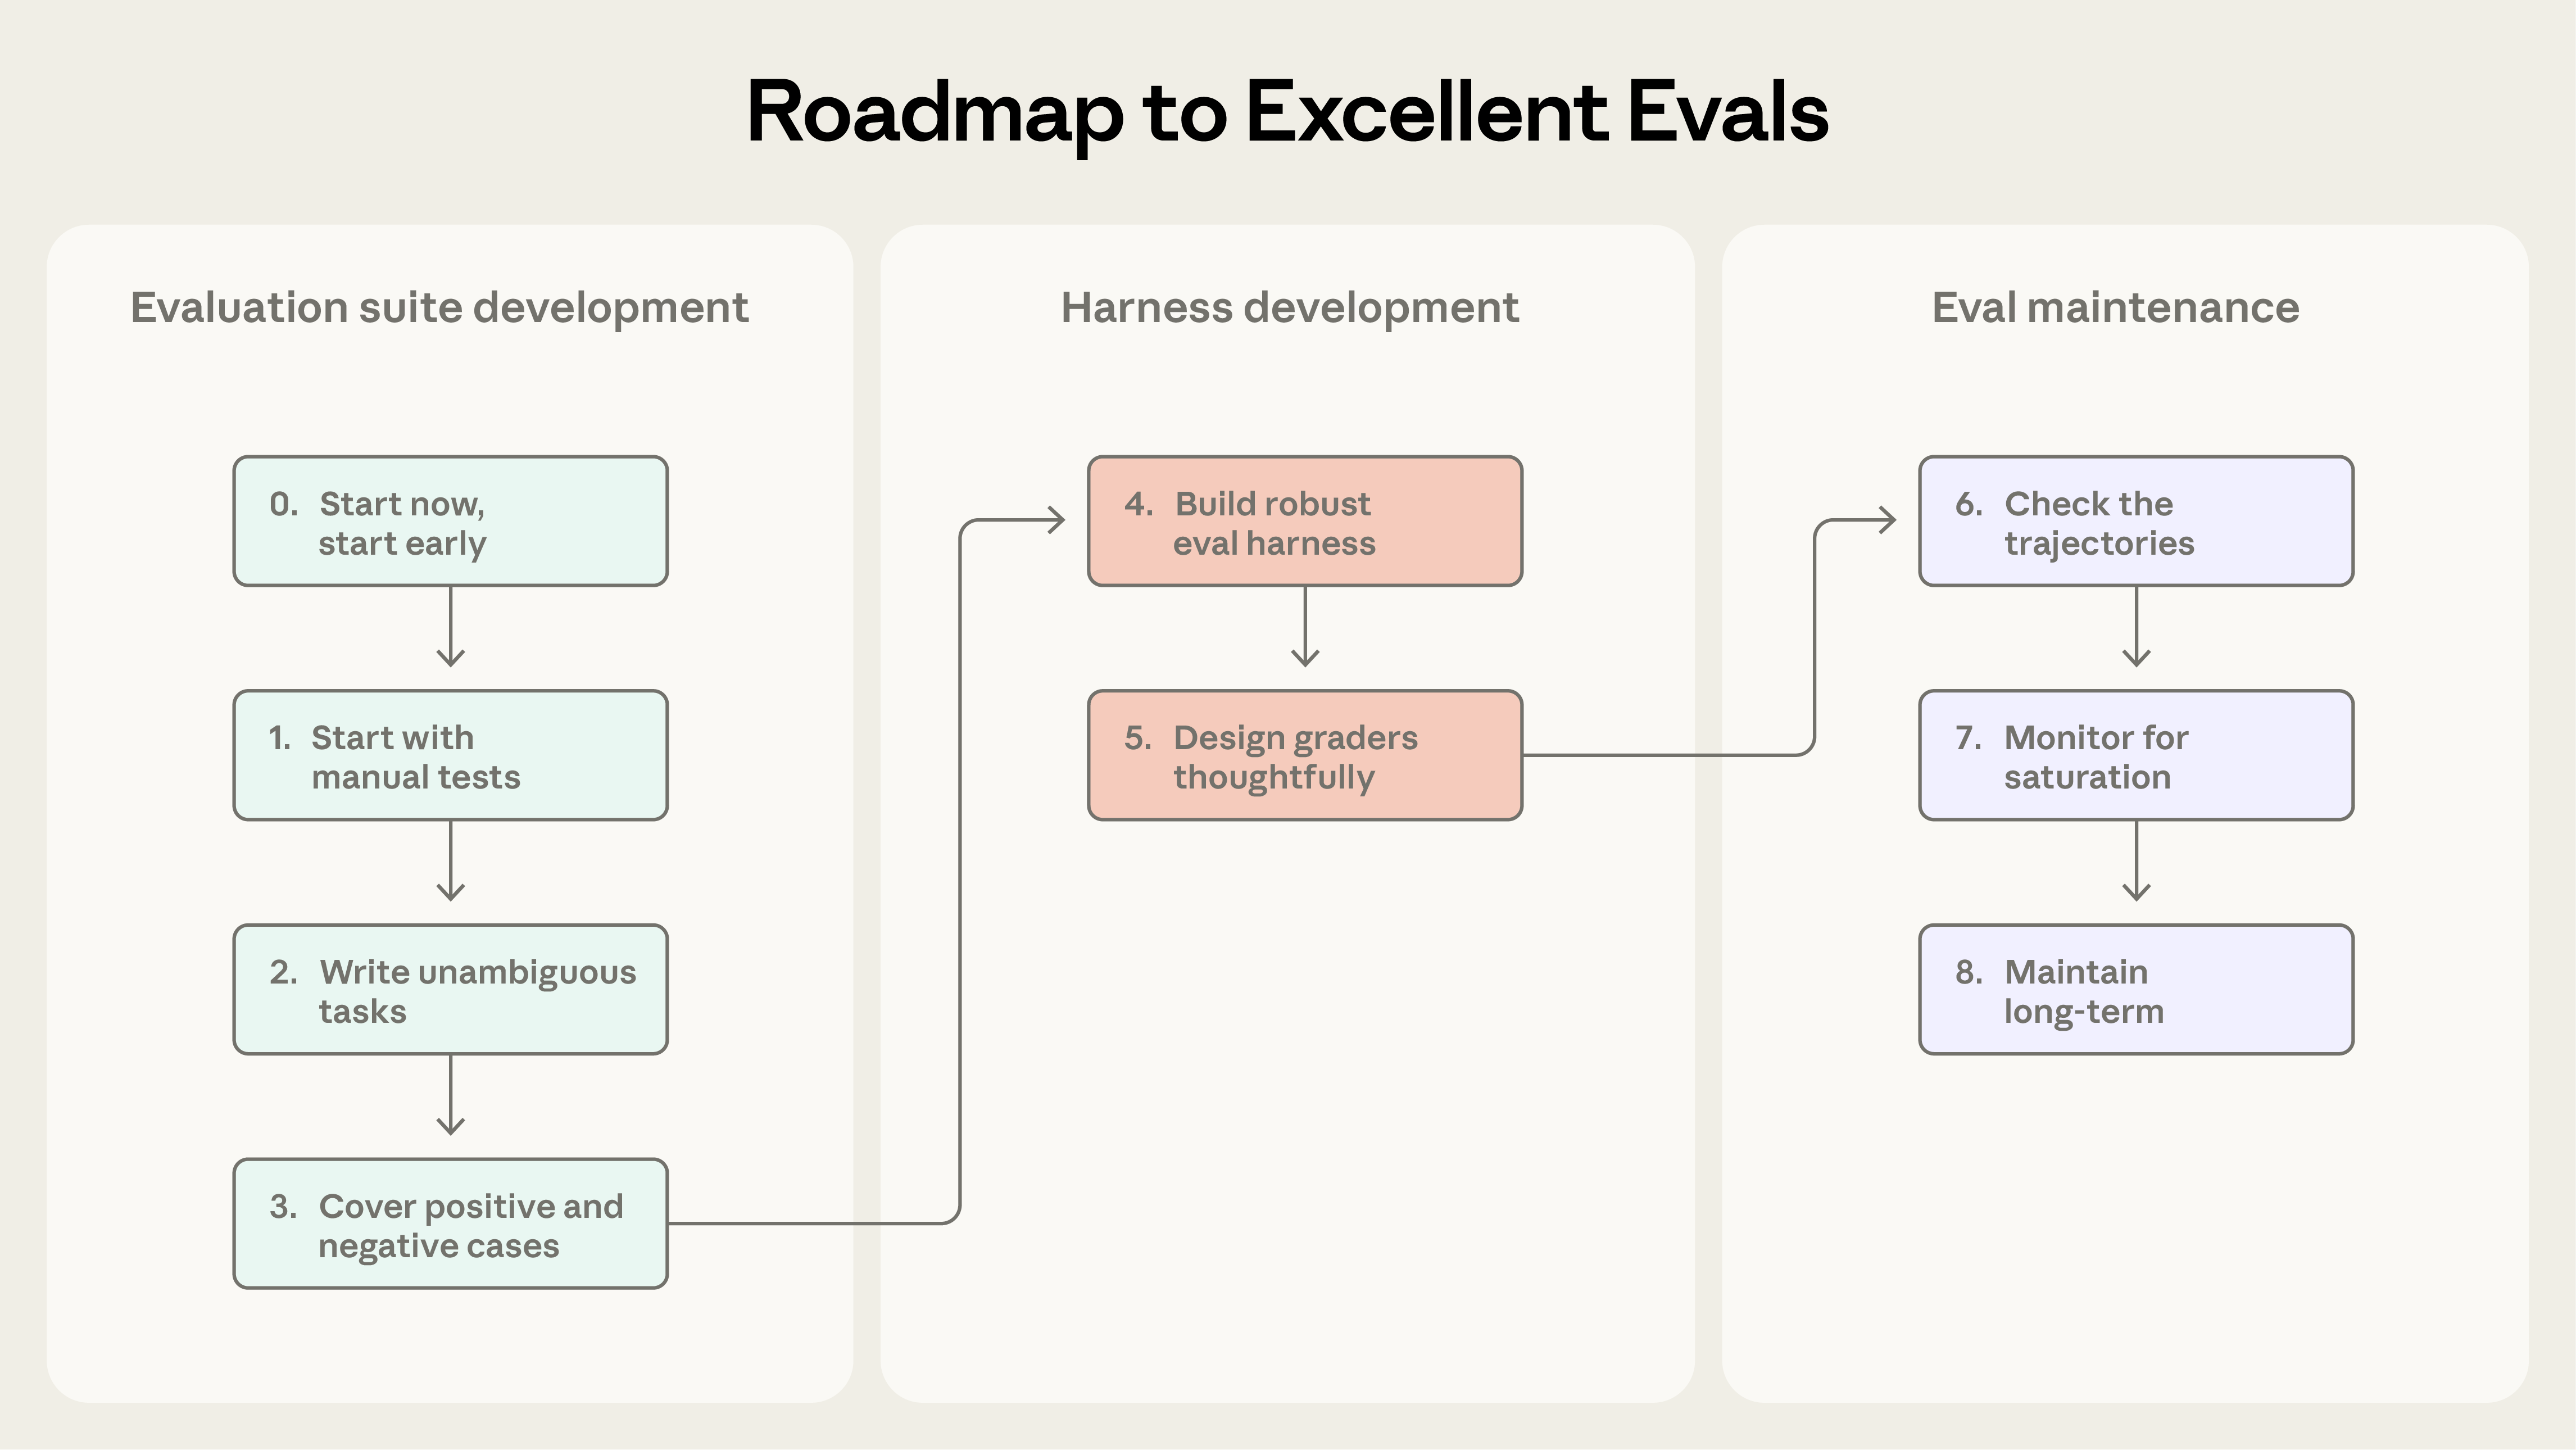
Evaluation suite 개발, harness 개발과 장기 유지보수로 이어지는 로드맵. 출처: Anthropic, Demystifying evals for AI agents.
Collect tasks for the initial eval dataset
- 일찍 시작: 실제 failure에서 가져온 수십 개의 명확한 task로 출발; 완벽한 대규모 suite를 기다리지 않음
- 수동 검사 재사용: release checklist, 자주 쓰는 workflow, bug tracker, support 사례를 후보로 수집
- 모호함 제거: grader의 요구사항을 task 설명에 명시; 알려진 정상 해법이 실제로 통과하는지 검증
- 균형 잡힌 구성: 쉬운 사례·production failure의 과대표집 방지; capability·난이도·positive·negative case 고려
Design the eval harness and graders
- 안정적인 harness: trial마다 깨끗한 환경으로 격리; file·cache·resource 공유로 인한 오류와 성능 부풀림 방지; 실제 agent 동작과 환경 차이 점검
- 신중한 grader: 문제에 맞게 code·model·human 판정 조합; rigid한 exact match·모호한 rubric이 정상 답을 실패시키는지 확인
- 경로 강제 주의: 특정 tool 순서보다 결과 중심 판정; 필수 정책·확인 단계는 명시적 계약으로 검사
- Model judge 교정: human 판단과 대조하고, 정보가 부족하면 불확실성을 표현하도록 설계
Maintain and use the eval long-term
- Trajectory 직접 검토: transcript와 판정 근거를 읽고 agent 오류·grader 오류 구분; 실패 이유가 납득 가능한지 확인
- 포화 감시: 거의 모두 통과하는 task는 regression으로 유지; 더 어려운 failure mode로 capability suite 보강
- 지속 관리: product·research·domain expert가 task에 기여; 낡거나 중복된 task·grader 정리
How evals fit with other methods
Automated eval, production signal, human review는 서로 다른 빈틈을 보완하는 평가 계층이다.
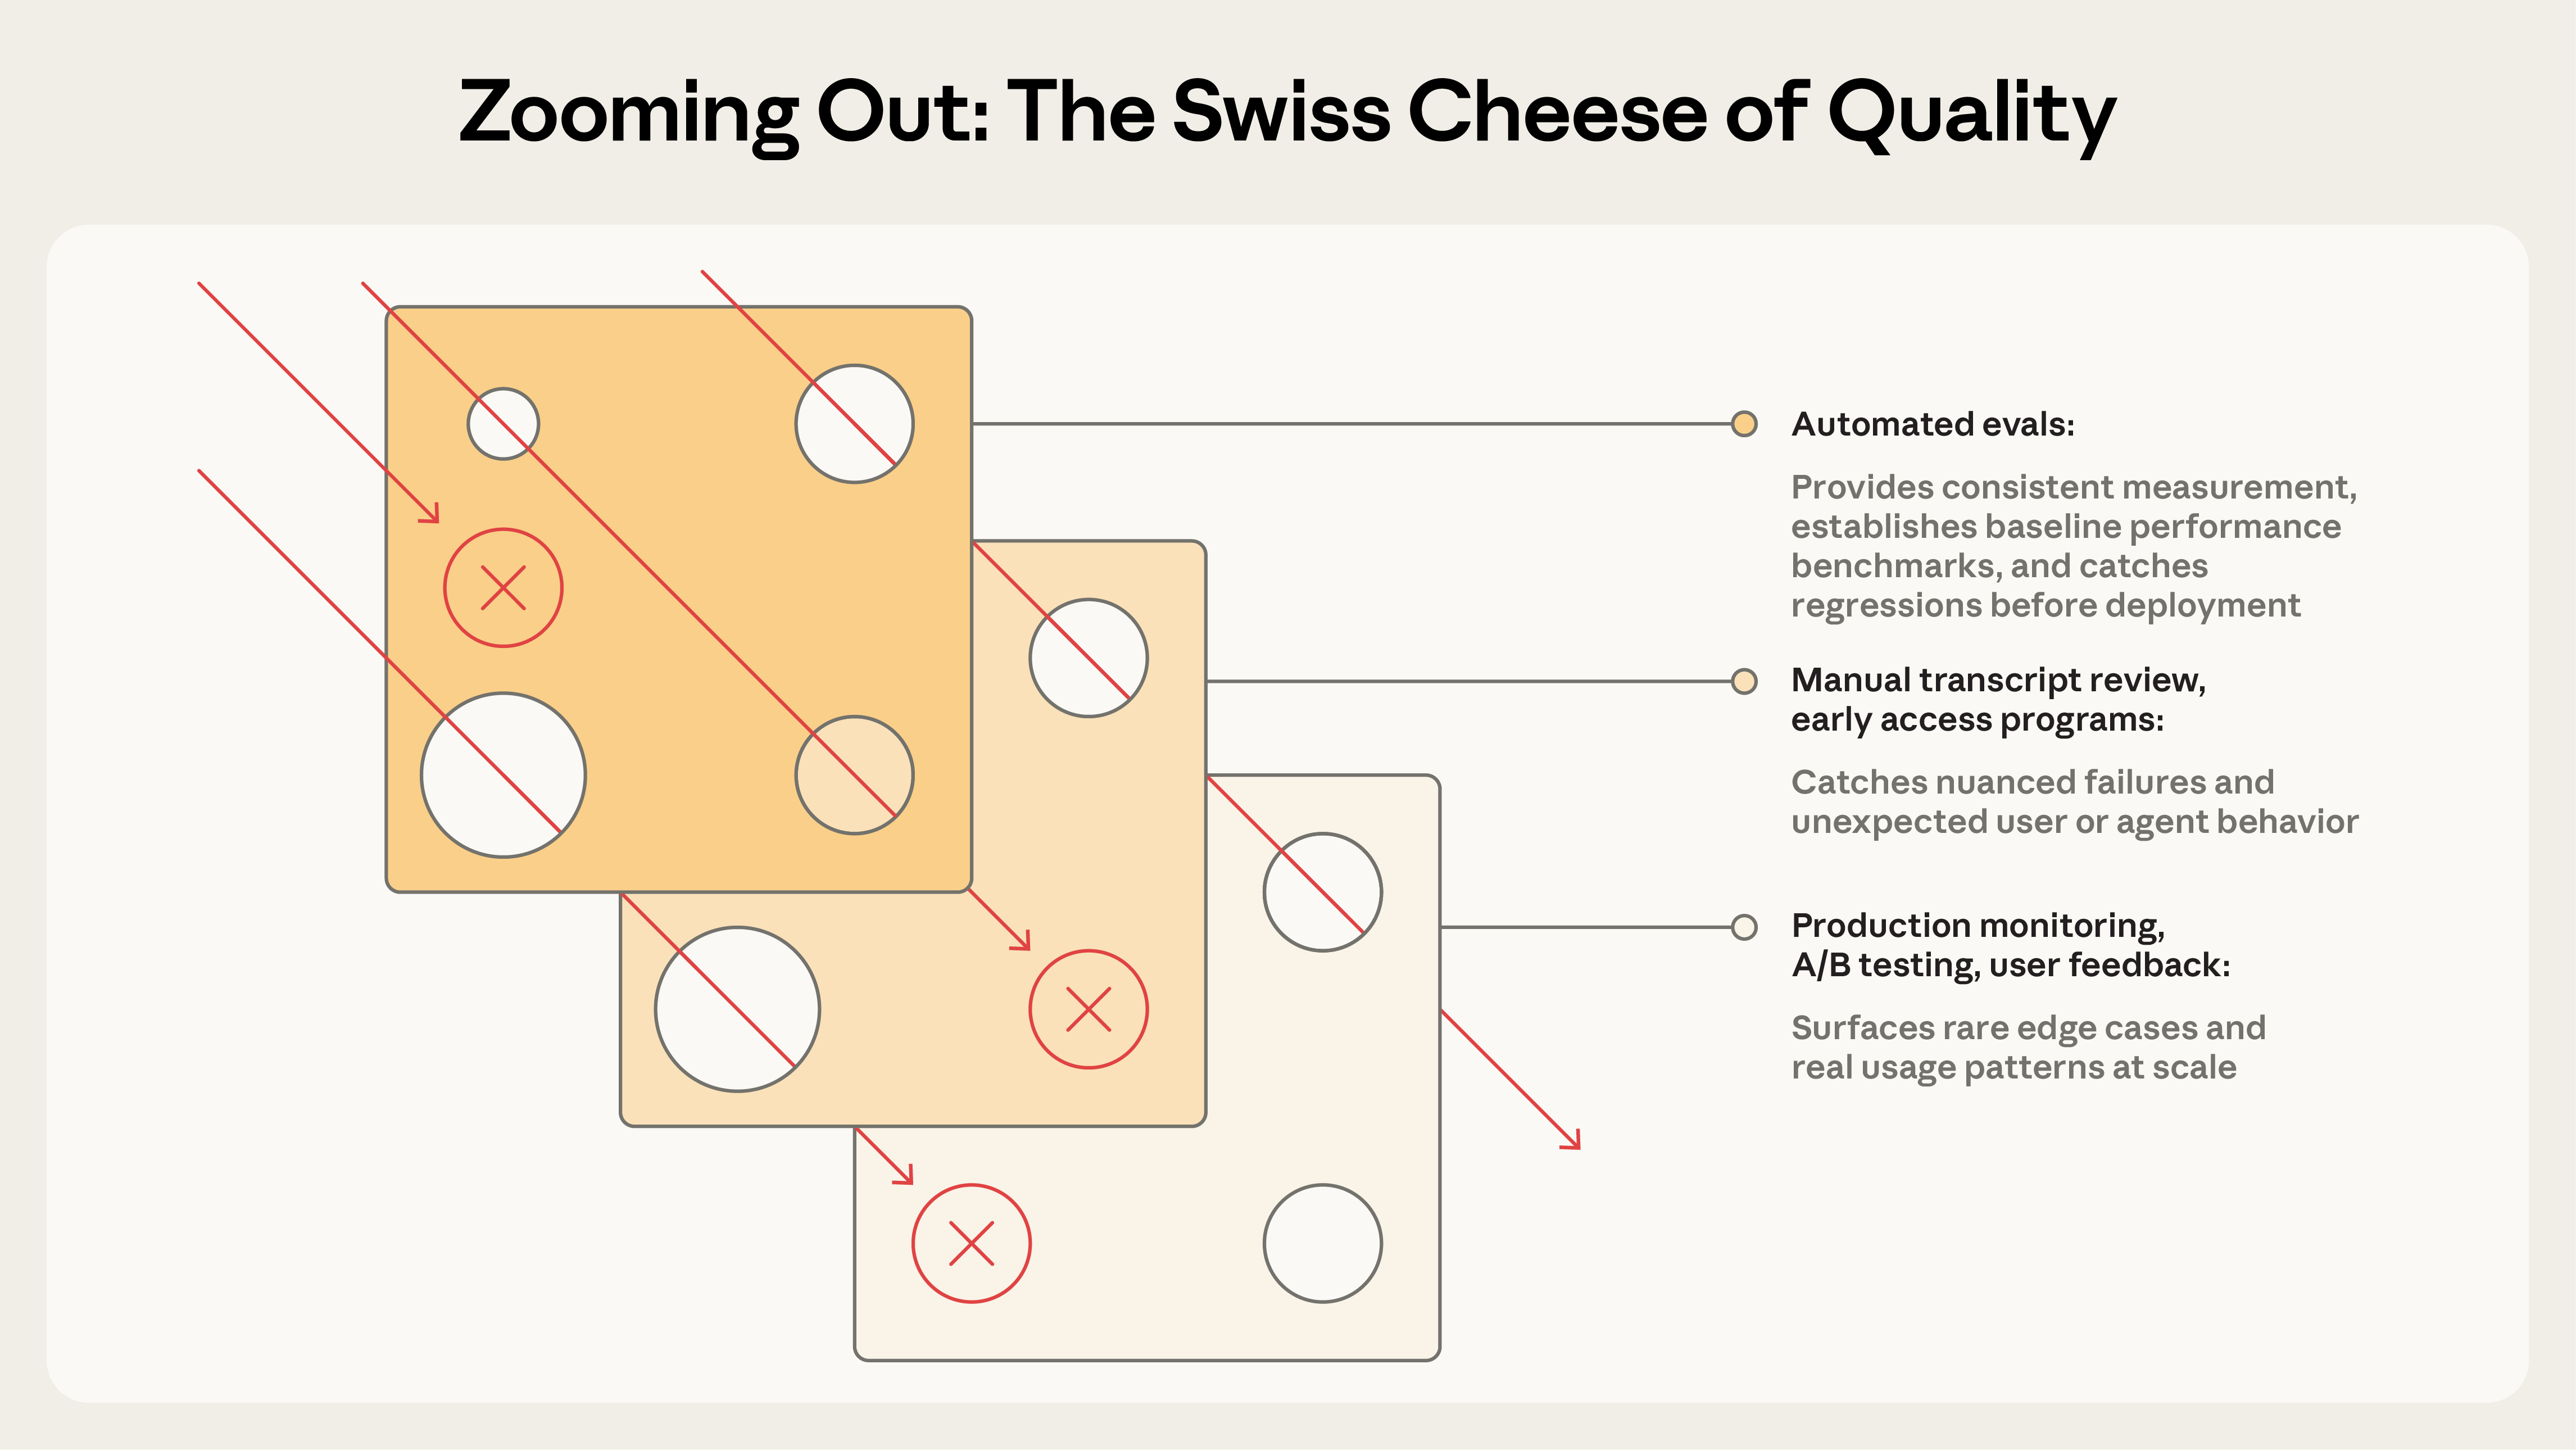
어떤 평가 계층도 모든 문제를 잡지 못하므로 여러 방법을 결합해야 한다는 Swiss Cheese Model. 출처: Anthropic, Demystifying evals for AI agents.
- Automated eval의 역할: launch 전 변경 비교, CI regression 방지
- 한계: 실제 사용 분포·예상하지 못한 failure·주관적 품질 전체를 대표하지 못함
- 아래 표: 원문에서 별도 그림이 아닌 비교표로 제시한 overview를 요약
| 방법 | 강점 | 한계 |
|---|---|---|
| Automated eval | 빠른 반복·동일 조건 재실행; 사용자 영향 없이 commit마다 많은 scenario 검사 | 초기 구축·지속 유지보수 필요; 실제 분포와 다르면 잘못된 확신 |
| Production monitoring | 실제 사용자 행동·대규모 운영 신호 관찰; synthetic eval이 놓친 문제 발견 | 사용자에게 문제 도달 후 발견; noise와 정답 label 부재 |
| A/B testing | Retention·task completion 등 사용자 결과 비교; 교란 요인 통제 | 충분한 traffic·통계적 유의성 확보 시간 필요; 배포한 변경만 비교, 원인 설명 제한 |
| User feedback | 예상 밖 문제·실제 사례; product goal과 가까운 신호 | 희소성·self-selection bias; 심각한 문제 편중, 실패 이유 누락 |
| Manual transcript review | 미묘한 failure·맥락 확인; 좋은 behavior에 대한 팀의 판단 기준 형성 | 시간 소모·확장 한계; 낮은 coverage·reviewer 일관성, 주로 정성적 신호 |
| Systematic human study | 구조화된 주관적 판단 기준; model grader 개선에 활용 | 높은 비용·느린 turnaround; 평가자 불일치 조정·전문가 필요 |
- 개발 feedback: automated eval
- 실제 분포 확인: production monitoring
- 주관적 판단·grader calibration: human review
Conclusion
평가 체계는 완성된 test set이 아니라 agent와 함께 진화하는 product component다.
- 일찍 시작: 완벽한 suite 대신 실제 failure에서 출발
- 성공 조건 명시: 현실적인 task와 명확한 grader로 변경 검증
- 개선 신호 유지: model 간 차이를 드러낼 어려운 문제 확보
- 측정 자체 점검: 점수뿐 아니라 transcript를 읽고 signal-to-noise 개선
- 변화에 대응: 더 긴 task, multi-agent collaboration, 주관적 작업에 맞춰 평가도 갱신
Appendix: Eval frameworks
Framework는 실행을 돕지만, 평가 품질은 task와 grader의 품질에 달려 있다.
- 선택 기준: agent 유형, 기존 stack, offline evaluation·production observability의 필요한 범위
- 표의 범위: 원문 부록이 소개한 도구와 역할 요약; 최신 기능·순위 비교가 아님
| 원문에 소개된 도구 | 강조하는 범위 |
|---|---|
| Harbor | Containerized environment의 task·grader 표준화, 대규모 trial 실행 |
| Braintrust | Offline evaluation, production observability, experiment tracking |
| LangSmith | LangChain 생태계의 tracing·dataset·offline/online evaluation |
| Langfuse | Self-hosted open-source tracing·evaluation, data residency 요구 대응 |
| Phoenix / Arize AX | Open-source tracing·debugging·evaluation 및 관리형 monitoring |
- 도입 방식: 작은 script로 시작하거나 여러 도구 조합 가능
- 투자 우선순위: workflow에 맞는 도구 선택 후 test case·grader 반복 개선
이 시리즈의 고민과 연결하면
Task·test case는 여전히 기본 단위이며, environment·grader·반복 trial을 가진 실행 가능한 문제로 확장된다.
- 이 절의 성격: 원문을 바탕으로 한 작성자의 해설과 시리즈 설계 연결
- 핵심 질문: TC 사용 자체보다 모든 위험을 하나의 canonical trajectory·fixture로 표현했는지 점검
| 위험·목적 | 시리즈에서 연결할 평가 방식 |
|---|---|
| 운영에서 발견한 실패 | Production trace·사용자 feedback에서 failure candidate 선별 |
| 알려진 회귀 | 작고 결정적인 replay TC로 고정 |
| 상태 변화·긴 상호작용 | Sandbox·simulator에서 task 실행 |
| 결과와 과정의 품질 | Outcome·transcript에 각각 맞는 grader 적용 |
| 비결정성·실제 분포 | 여러 trial과 production monitoring으로 보완 |
- 회고 기준: curation·유지보수 비용, outcome 검증, environment fidelity가 충분했는지 확인
- 해석 주의: 위 연결은 특정 평가 방식 하나를 모든 task의 정답으로 제시하는 의미가 아님